※この記事にはプロモーションが含まれます
前回はGPT-6 Astraの概要と、Python SDKで最初のリクエストを投げるところまでを紹介しました。とりあえず返事は返ってきた。でも「このパラメータ何?」「レスポンスの中身ってどうなってるの?」がよくわからないまま、という状態だったので、今回はそこを掘り下げます。最後に、ターミナルで会話できる簡単なチャットボットまで作ってみます。
ちなみにGPT-6 Astraは2026年9月3日ごろに段階的ロールアウト(限定→数日で広く利用可)という形で公開されたOpenAIのフラッグシップモデルで、APIのモデルIDは gpt-6-astra です。コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークンと発表されています。
この記事でわかること
- Responses APIでよく使うパラメータ(instructions / reasoning / max_output_tokens など)の役割
- レスポンスオブジェクトの構造と、テキスト・トークン数の取り出し方
- usageから1リクエストあたりのコストをざっくり計算する方法
previous_response_idを使った会話の続け方と、最小構成のチャットボット
おさらい:Responses APIの基本形
前回の最小コードはこんな感じでした。OPENAI_API_KEY は環境変数に入れている前提です。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="AWS Lambdaのコールドスタートを一言で説明して",
)
print(response.output_text)
これで動きはします。ただ実際に何か作ろうとすると、「キャラ付けしたい」「出力が長すぎる」「料金が怖い」あたりが気になってきます。で、それを調整するのがパラメータ、という流れです。
よく使うパラメータを整理する
全部のパラメータを網羅するのは無理なので、チャットボットを作るのに必要そうなものだけ調べてみました。
instructions:システムプロンプト的なもの
Chat Completions時代の system メッセージにあたるのが instructions です。モデルの役割や口調、守ってほしいルールをここに書きます。
response = client.responses.create(
    model="gpt-6-astra",
    instructions="あなたはAWSに詳しいアシスタントです。回答は3文以内で、初心者にもわかる言葉で。",
    input="SQSとEventBridgeの違いは?",
)
ハマりかけたのが、instructions はそのリクエストにだけ効くという点。後で出てくる previous_response_id で会話をつないでも、前回の instructions は引き継がれないらしいです。なので、毎回渡すのが無難かなと。
reasoning:考える量の調整
GPT-6 Astraは推論モデルなので、回答前に「考える」工程があります。その深さを reasoning の effort で指定します。
response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "low"},
    input="DynamoDBのパーティションキー設計で気をつけることは?",
)
effortを上げるほど難しい問題に強くなる代わりに、待ち時間と推論トークン(=料金)が増えます。雑談レベルのチャットボットなら low、コードレビューや設計相談なら medium 以上、みたいな使い分けが良さそうです。公式のモデルページで最新の値一覧を確認するのが確実かもしれません。
max_output_tokens:出力の上限
出力トークンの上限です。ここで注意したいのが、推論トークンもこの上限に含まれること。たとえば500とかに絞ると、考えている途中で上限に達して、本文がほぼ空のまま返ってくることがあります。このとき response.status が "incomplete" になって、incomplete_details.reason に "max_output_tokens" が入る仕様です。
if response.status == "incomplete":
    print("途中で切れた:", response.incomplete_details.reason)
temperatureはどうなの?
Chat Completions時代の癖で temperature を渡したくなりますが、推論モデル系だと temperature はサポートされていないことがあるようです。自分は「出力の調整は effort とプロンプトでやる」と割り切っています。
レスポンスの中身を解析する
output_text は便利ですが、中身を知っておくとデバッグがかなり楽になります。response.model_dump() で辞書にすると、だいたいこんな構造になっています(値は説明用のダミーです)。
status:completed/incompleteなどoutput:配列。reasoningアイテムとmessageアイテムが並ぶusage:入力・出力トークン数。キャッシュ分や推論分の内訳もある
ポイントは、output の先頭が必ずしもメッセージとは限らないこと。response.output[0].content[0].text みたいに決め打ちで取ると、reasoningアイテムが先に来たときに落ちます。typeを見てフィルタするのが安全です。
APIを叩かずに構造だけ確認できるように、ダミーのレスポンスを辞書で再現して、テキスト抽出とコスト計算をするスクリプトを書いてみました。料金は公式発表の1Mトークンあたり入力$10、キャッシュ入力$1、出力$50で計算しています。
sample = {
    "id": "resp_abc123",
    "model": "gpt-6-astra",
    "status": "completed",
    "incomplete_details": None,
    "output": [
        {"type": "reasoning", "id": "rs_001", "summary": []},
        {
            "type": "message",
            "id": "msg_001",
            "role": "assistant",
            "content": [
                {"type": "output_text", "text": "Lambdaのコールドスタートは、初回起動時の初期化処理が原因です。"}
            ],
        },
    ],
    "usage": {
        "input_tokens": 1200,
        "input_tokens_details": {"cached_tokens": 800},
        "output_tokens": 950,
        "output_tokens_details": {"reasoning_tokens": 700},
    },
}

PRICE = {"input": 10.00, "cached": 1.00, "output": 50.00}  # USD / 1M tokens


def extract_text(resp):
    texts = []
    for item in resp["output"]:
        if item["type"] != "message":
            continue
        for c in item["content"]:
            if c["type"] == "output_text":
                texts.append(c["text"])
    return "".join(texts)


def estimate_cost(usage):
    cached = usage["input_tokens_details"]["cached_tokens"]
    fresh = usage["input_tokens"] - cached  # ここ注意: input_tokensはキャッシュ分込み
    out = usage["output_tokens"]
    return (fresh * PRICE["input"] + cached * PRICE["cached"] + out * PRICE["output"]) / 1_000_000


print("status :", sample["status"])
print("text   :", extract_text(sample))
u = sample["usage"]
print("reasoning tokens:", u["output_tokens_details"]["reasoning_tokens"], "/", u["output_tokens"])
print(f"cost   : ${estimate_cost(u):.6f}")
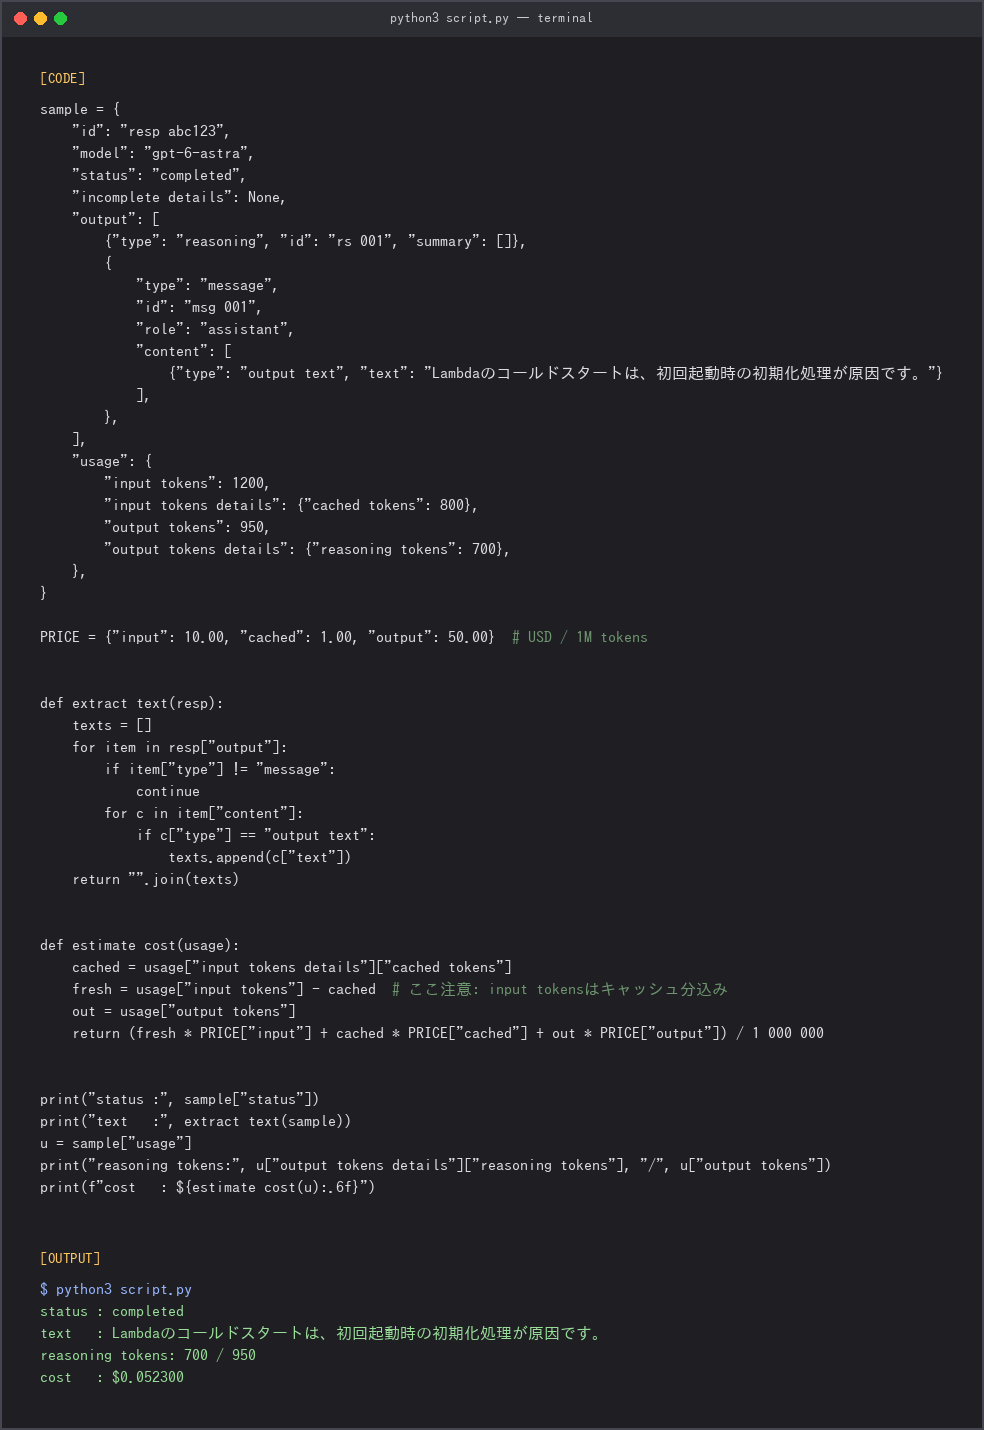
▲実際にこのブログの裏側で実行してみた結果です
実行するとこうなります。
status : completed
text   : Lambdaのコールドスタートは、初回起動時の初期化処理が原因です。
reasoning tokens: 700 / 950
cost   : $0.052300
見てほしいのは、出力950トークンのうち700が推論トークンになっているところ。ユーザーに見える本文は短くても、裏で考えた分はしっかり出力単価で課金されます。出力$50/1Mはなかなかの単価なので、effortを上げっぱなしにすると地味に効いてきそうです。
会話をつなぐ:previous_response_id と自前の履歴管理
チャットボットにするには「前の発言を覚えている」必要があります。やり方は大きく2つあるっぽいです。
- previous_response_id を渡す:サーバー側に保存された前回のレスポンスを起点に会話を続ける。コードが楽
- 履歴を自分で配列管理して input に渡す:手間は増えるけど、何を送っているか完全に把握できる
楽なのは前者です。ただ誤解しやすいのが、previous_response_id を使っても過去の会話分は入力トークンとして毎回課金されるという点。「サーバーが覚えてくれるからタダ」ではないです。会話が長くなるほど1ターンのコストが上がっていきます。
自前管理の場合は、古い履歴を切り捨てる処理を入れておくと安心です。こんな感じの単純なものでも、とりあえずは役に立ちます。
def trim_history(history, max_turns=3):
    system = [m for m in history if m["role"] == "developer"]
    convo = [m for m in history if m["role"] != "developer"]
    return system + convo[-max_turns * 2:]


history = [{"role": "developer", "content": "あなたはAWSに詳しいアシスタントです。"}]
for i in range(1, 6):
    history.append({"role": "user", "content": f"質問{i}"})
    history.append({"role": "assistant", "content": f"回答{i}"})

for m in trim_history(history):
    print(m["role"], ":", m["content"])
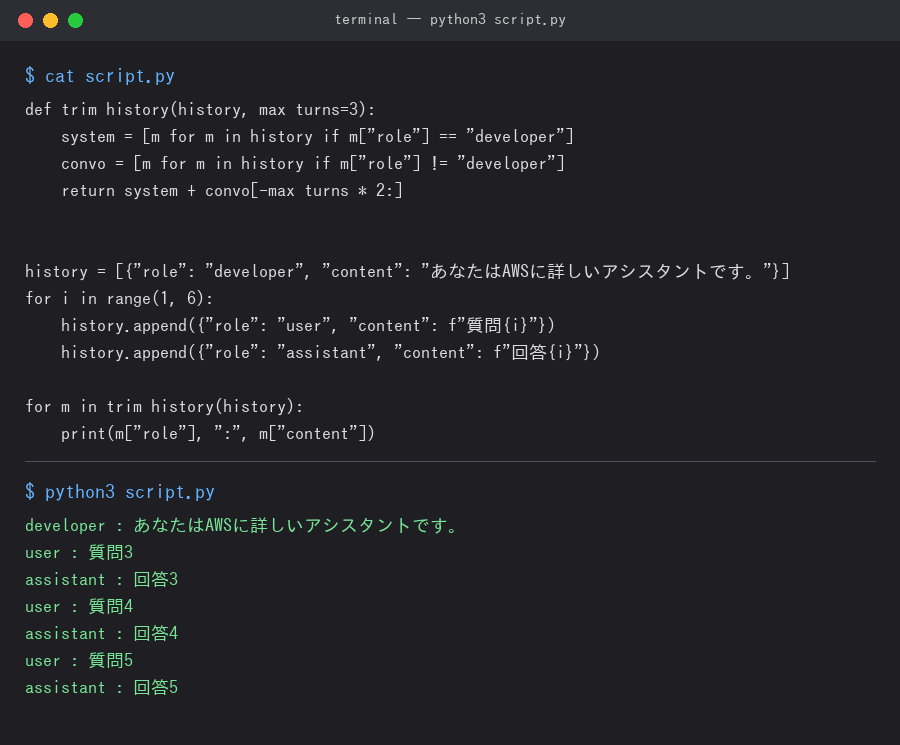
▲実際にこのブログの裏側で実行してみた結果です
developer : あなたはAWSに詳しいアシスタントです。
user : 質問3
assistant : 回答3
user : 質問4
assistant : 回答4
user : 質問5
assistant : 回答5
本当は「古い履歴を要約して残す」ほうが賢いんですが、それは要約のために別のAPI呼び出しが要るので今回は見送りました。
ターミナルで動くチャットボット
ここまでの内容をまとめて、previous_response_id 版のチャットボットを書いてみました。実際にAPIを叩くので、APIキーと課金設定が必要です。
from openai import OpenAI

client = OpenAI()

INSTRUCTIONS = "あなたはAWSに詳しいアシスタントです。回答は簡潔に、日本語で。"
PRICE_IN, PRICE_CACHED, PRICE_OUT = 10.0, 1.0, 50.0

prev_id = None
total_cost = 0.0

while True:
    user_input = input("you> ").strip()
    if user_input in ("exit", "quit"):
        break
    if not user_input:
        continue

    response = client.responses.create(
        model="gpt-6-astra",
        instructions=INSTRUCTIONS,  # 毎回渡す
        input=user_input,
        previous_response_id=prev_id,
        reasoning={"effort": "low"},
        max_output_tokens=4000,
    )

    if response.status == "incomplete":
        print(f"[途中で切れました: {response.incomplete_details.reason}]")

    print("bot>", response.output_text)

    u = response.usage
    cached = u.input_tokens_details.cached_tokens
    cost = ((u.input_tokens - cached) * PRICE_IN + cached * PRICE_CACHED
            + u.output_tokens * PRICE_OUT) / 1_000_000
    total_cost += cost
    print(f"  (in={u.input_tokens}, out={u.output_tokens}, ${cost:.4f} / 累計 ${total_cost:.4f})")

    prev_id = response.id
毎ターンのトークン数と累計コストを表示するようにしたのは完全に自衛のためです。会話を重ねると in= の数字がじわじわ増えていくのが見えるので、「過去分も毎回課金される」が体感でわかります。
正直なところ、エラー処理(レート制限やタイムアウト)はまだ全然入れていません。openai.RateLimitError あたりを拾ってリトライする処理は本番なら必須だと思うので、そこは宿題です。
PR(アフィリエイト広告)
ちなみに、GPT-6 Astra APIでPythonの文字起こし処理を試しながら、会議の音声入力もAIで自動化できたら楽だなと思って調べてたら、PLAUD NOTE というAIボイスレコーダーが気になってます。
まとめ
- instructions は毎回渡す。previous_response_id では引き継がれない
- max_output_tokens には推論トークンも含まれるので、絞りすぎると本文が空になる
- output は type でフィルタして取り出す。先頭の要素を決め打ちで取らない
- usage を見れば推論トークンやキャッシュの内訳までわかる。コストはそこから計算できる