※この記事にはプロモーションが含まれます
先月、個人のLambdaで動かしてる要約バッチのモデルを上げようとして、うっかり temperature を渡したまま400を返され続けて30分くらい溶かしました。悪いのは完全に自分です。
というわけで、GPT-6 Astra のAPIを一度ちゃんと触って整理しておこうと思い、シリーズにしてみました。全4回の予定で、だいたいこんな流れです。
- 第1回(今回):環境構築、APIキーの設定、最初のリクエスト
- 第2回:Function Calling / Structured Outputs
- 第3回:ストリーミングと非同期ツール呼び出しあたり
- 第4回:AWS Lambdaに載せて実運用っぽくする
あくまで自分の学習メモなので、抜けてるところは普通にあると思います。そのあたりは温かい目で見てください。
この記事でわかること
- GPT-6 Astra の基本スペック(モデルID・コンテキスト長・料金)
- Python での環境構築手順(uv / pip 両方)
- APIキーの安全な置き場所とロードの仕方
- Responses API で最初のリクエストを送るまでのコード
- Astra 特有の「これ使えないの!?」という地雷ポイント
- 料金をざっくり見積もるための小さなスクリプト
GPT-6 Astra のおさらい
まず前提の確認から。GPT-6 Astra はOpenAIの最新フラッグシップモデルで、APIのモデルIDは gpt-6-astra、コンテキストウィンドウは100万トークン級です。正確には1,050,000トークンのコンテキストで、最大出力は128,000トークン、入力はテキストと画像に対応し出力はテキストとのこと。
料金は(標準の目安として)入力100万トークンあたり$10、出力$50あたりがベースです。ただしキャッシュや長文入力の条件次第でレートが変わるので、「キャッシュ入力は常に$1」みたいに決め打ちせず、実際は公式の料金条件を見ながら計算するのが安全です。特に入力が長いリクエストは、入力・キャッシュ・出力で倍率が変わる設定が入っています。正直、個人の趣味開発で雑に投げるには結構いい値段です。出力$50/1Mって、日本円だと1万トークン出させるだけで70円くらいですからね……。用途は選びたい。
得意領域としては高度な分析、ソフトウェアエンジニアリング、ディープリサーチ、科学研究、ドキュメント作成あたりが挙げられることが多くて、特に長い文脈を扱う複雑なタスクに強みがあるとも言われています。つまり「軽いチャット」より「長い仕事を投げる」側のモデルっぽい。
公開範囲については、OpenAI API、Microsoft Azure、AWS Bedrock 経由でも利用可能になっているようです。Bedrockにも来てるのは、AWS側に寄せてる人間としてはちょっと嬉しいところ。ただ今回はOpenAIのAPIを直接叩きます。
環境構築
Python SDK を入れるだけなので、ここは本当にあっさりです。公式も pip install openai でOK。
pip install openai python-dotenv
自分は最近は uv を使っているので、実際にはこっちでした。
uv init astra-practice
cd astra-practice
uv add openai python-dotenv
Pythonのバージョンについては、新しいSDKの機能を使うなら新しめのほうが無難だと思うので、自分は3.13系で揃えました。3.9以下はもう諦めたほうが精神衛生に良さそうです。
APIキーの設定
キーは platform.openai.com で発行して、環境変数に置きます。各SDKはシステムの環境変数からAPIキーを自動で読んでくれるはずなので、コードに直接書く必要はありません。
export OPENAI_API_KEY="sk-proj-..."
ただこれ、ターミナルを閉じると消えるんですよね。毎回exportするのが面倒なので、自分はプロジェクトごとに .env を置いて python-dotenv で読む派です。
OPENAI_API_KEY=sk-proj-xxxxxxxxxxxx
echo ".env" >> .gitignore
この .gitignore への追記、本当に最初にやってください。自分は昔、別のサービスのキーを含んだファイルをpublicリポジトリに上げてしまって、10分後にGitHubからアラートメールが来るという体験をしています。即revokeしたので被害はなかったんですが、心臓に悪い。
最初のリクエストを送る
Astra は Responses API が基本です。キーを置いたら dotenv でロードして、OpenAIクライアントを作って client.responses.create() で投げる、という流れ。
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "low"},
    input="ステージング環境は何のために使うものですか。1文で説明してください。",
)

print(response.output_text)
print(response.usage)
これで返ってきます。output_text は便利なんですが、ここで一個注意点があって、output_textはテキスト出力をまとめて読むための便利プロパティで、ツール呼び出しや複数種類の出力を扱う場合は response.output の各itemを type で判定する必要があるとのこと。すべての出力が message とは限らないので、配列の先頭だけを決め打ちして読むのは避けたほうがいいそうです。
これ、第2回のFunction Callingで確実に踏むポイントなので、今のうちに「output[0] 直読みはしない」と刻んでおきます。推論モデルだと先頭に reasoning item が来ることがあるので、素直に書くと普通に壊れるはず。
ツール呼び出し(function_call を受け取って結果を返す2往復)の実装は、「GPT-6 Astra APIのツール呼び出し入門|PythonでResponses APIを2往復させる実装」に先にまとめています。
Astra の地雷ポイント(ここで30分溶かした)
冒頭の話に戻ります。Astra には使えないパラメータがあるようです。
まず reasoning effort。low、medium、high、xhigh、max がサポートされていて、none はサポートされていないという話を見かけます。none を指定するとHTTP 400が返ることがあるようなので、このへんは公式リファレンスを見ながら確認するのが良さそうです。GPT-5系で minimal を使っていた場合は、まず low から始めて比較するのが推奨とされています。
そしてサンプリング系。temperature、top_p、logprobs は非対応と言われています。自分がハマったのはここ。GPT-4の時代から雑にコピペしてきた temperature=0.2 が、関数のデフォルト引数の奥に埋まったまま生き残っていました。エラーメッセージはちゃんと教えてくれていたのに、最初モデルIDのtypoを疑って見当違いの場所を見ていたのが敗因です。
もう一つはAPIの選択。GPT-6 Astra は Chat Completions もサポートしているという話もありますが、少なくともツール呼び出しや複数イベント(message以外)を扱う前提だと、Responses API に寄せておくのが素直かなと思います。
余談ですが、会話の途中で configuration_update という入力アイテムを追加して、プロンプトの前半を書き換えずに reasoning effort を上げ下げできる(キャッシュを保ったまま)という機能があるらしく、これは結構面白そうです。難しいところだけ effort を上げて、定型の追加質問は下げる、みたいな使い方ができるっぽい。ここはまだ自分で試せてないです。
料金をざっくり見積もるスクリプト
出力$50/1M という価格を見て若干ビビったので、手元で計算できる小さいスクリプトを書きました。APIを叩かないので、キーなしでそのまま動きます。
PRICE = {"input": 10.0, "cached_input": 1.0, "output": 50.0}
USD_JPY = 150

def estimate(input_tokens, output_tokens, cached_tokens=0, usd_jpy=USD_JPY):
    fresh = input_tokens - cached_tokens  # ここ注意: cached は input の内訳
    usd = (
        fresh / 1_000_000 * PRICE["input"]
        + cached_tokens / 1_000_000 * PRICE["cached_input"]
        + output_tokens / 1_000_000 * PRICE["output"]
    )
    return usd, usd * usd_jpy

cases = [
    ("短い質問1回", 500, 800, 0),
    ("長文要約1回", 120_000, 3_000, 0),
    ("同じ前置きで10回", 120_000, 3_000, 110_000),
]

for name, i, o, c in cases:
    usd, jpy = estimate(i, o, c)
    print(f"{name:<18} in={i:>7} out={o:>6} cached={c:>7} -> ${usd:.4f} / 約{jpy:.1f}円")
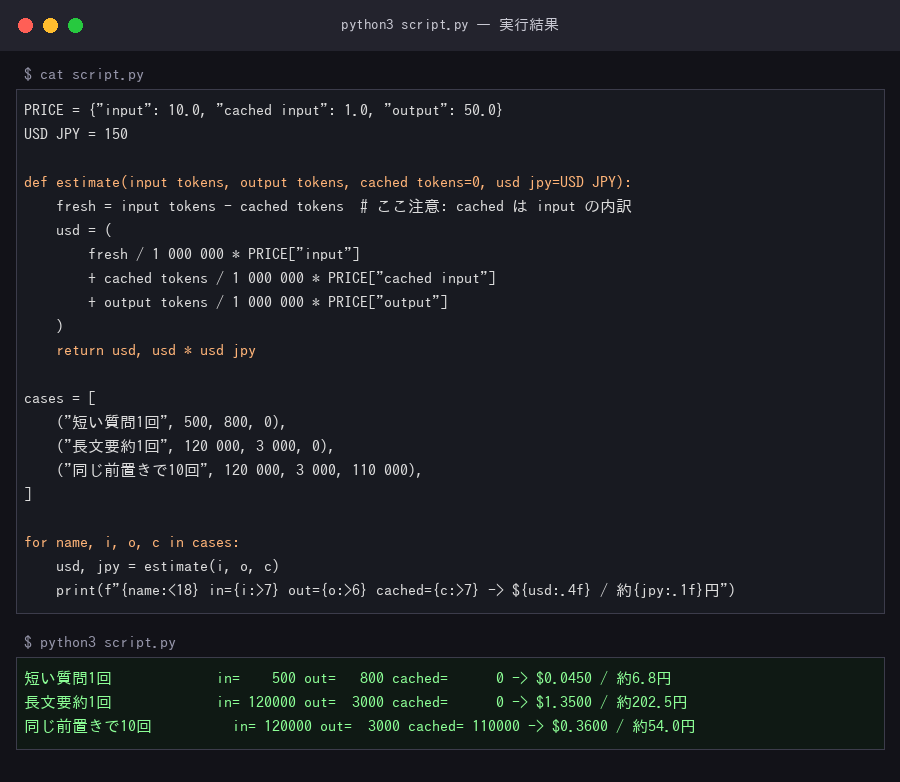
▲実際にこのブログの裏側で実行してみた結果です
3ケース目がキャッシュを効かせた場合です。キャッシュ入力が(条件次第で)かなり安くなるので、長い共通プレフィックスを使い回す設計にできるかどうかで、同じ処理でもコストが数倍変わります。条件に合うならバッチ/割引系に逃がすのも手だと思います。
なおこの計算、cached_tokens を input の内訳として扱っていますが、実際の response.usage のフィールド構成を自分はまだ完全には把握できていません。本番の金額を詰めるときは usage の実値とダッシュボードを突き合わせたほうがいいと思います。あくまで桁感を掴むための道具として。
※この記事にはプロモーションが含まれます
そういえば、GPT-6 Astra APIで画像生成の実験してたら出力結果が荒くて困ったんですが、調べてたらAiarty Image Enhancer ってツールがちょっと気になってます。
まとめ
第1回は環境構築とキー設定、最初のリクエストまででした。やることだけ並べると「SDK入れて responses.create 呼ぶ」の2行で終わる話なんですが、temperature と effort: none あたりが通らない(かもしれない)という1点だけは、旧コードを持ち込む人には刺さりやすいので強調しておきます。
次は Function Calling と Structured Outputs あたりを触っていきます。
📚 シリーズ「GPT-6 Astra API Python 実践入門」(第1回 / 全4回)
→ 次回の記事: 【第2回】GPT-6 Astra API Python 実践入門 — パラメータ設定とレスポンス解析でチャットボットを作る