Claude Fable 5.1の特徴、料金体系、Pythonでの実装方法を解説。キャッシュ読み込み料金の優位性や実際のコスト削減率も計算してみました。
先月ふと Bedrock のモデル一覧を眺めていたら見慣れない名前が増えていて、「Fable…?」となったのがきっかけです。調べたら Anthropic が2026年9月1日にリリースした最上位モデル、Claude Fable 5.1 でした。Fable 5 が出たのが6月なので、3ヶ月でマイナーアップデートという感じですね。
普段は Sonnet 系しか触っていない自分にとって「最上位モデルとか自分には関係ないかな」と思っていたんですが、料金表を見て少し考えが変わりました。以下、調べたことのメモです。
Claude Fable 5.1 の位置づけ
Claude の中でも Fable は「一般提供される中では最上位(frontier)モデル枠」という位置づけっぽいです。ややこしいのが Mythos 5.1 という同名の兄弟がいること。中身は同じ基盤モデルで、セーフガードのレベルが違うだけというのが公式の説明です。Mythos 側は一般提供ではなく、承認制の限定アクセス(approved partners など)で使えるモデルになっています。一般の開発者が触るのは Fable 5.1 のほうになります。
スペックはこんな感じです。
- モデルID:
claude-fable-5-1 - コンテキストウィンドウ: 1Mトークン / 最大出力 128Kトークン
- 思考(thinking): adaptive で常時オン、無効化できない
- 知識のカットオフ: 2026年6月
- 入力: テキストと画像 → 出力: テキスト
- リタイア予定: 2027年9月1日より前にはならない
「常時オン、無効化できない」がわりと重要で、後述しますが挙動と課金の両方に効いてきます。長時間動き続けるエージェント用途を明確に狙ったモデルっぽく、コードベース全体にまたがる機能追加とか、数時間走りっぱなしのジョブとかが想定用途として挙げられています。PDF の中に埋まった図表やチャートの読み取りが強くなったという話もあって、個人的にはちょっと気になっています。
料金体系:「キャッシュ読み込み」が本体
素の単価は以下のとおりです。
- 入力: $10 / 1Mトークン
- 出力: $50 / 1Mトークン
- キャッシュ書き込み(5分): $12.50 / 1Mトークン
- キャッシュ書き込み(1時間): $20 / 1Mトークン
- キャッシュ読み込み: $0.25 / 1Mトークン
- Batch API: 入出力ともに50%オフ
入出力だけ見ると普通に高いです。Opus 5 のだいたい2倍。でもキャッシュ読み込みが $0.25 で、これは Fable 5 の $1.00 から75%下がっています。通常 Claude 系のキャッシュ読み込みは入力単価の10%というのが相場なんですが、Fable 5.1 は入力 $10 に対して $0.25、つまり2.5%。この比率はかなり異質です。Sonnet 5 のキャッシュ読み込みと比べても25%程度しか高くないという話もあるようです。入力の素の単価は5倍あるのに。
Anthropic 自身も、これによって一般的なワークロードで実効コストが約25%、エージェント的な使い方だと最大45%程度下がると言っています。同じシステムプロンプト・同じツール定義・同じコードベースを何度も読み直すエージェントほど得をする設計、ということですね。
実際のコスト削減率を計算してみた
体感がつかめなかったので、電卓代わりのスクリプトを書きました。18万トークンの前提(コードベース+仕様書くらいのイメージ)を毎ターン読み直すエージェントを30ターン回す想定です。
IN, OUT, CACHE_READ, CACHE_WRITE_5M = 10.0, 50.0, 0.25, 12.50

def cost(fresh_in=0, cache_write=0, cache_read=0, out=0):
    return (fresh_in * IN + cache_write * CACHE_WRITE_5M
            + cache_read * CACHE_READ + out * OUT) / 1_000_000

turns, prefix, out_tok = 30, 180_000, 1_500

naive = turns * cost(fresh_in=prefix, out=out_tok)
cached = cost(cache_write=prefix, out=out_tok) + (turns - 1) * cost(cache_read=prefix, out=out_tok)

print(f"キャッシュなし: ${naive:,.2f}")
print(f"キャッシュあり: ${cached:,.2f}")
print(f"削減率        : {(1 - cached / naive) * 100:.1f}%")
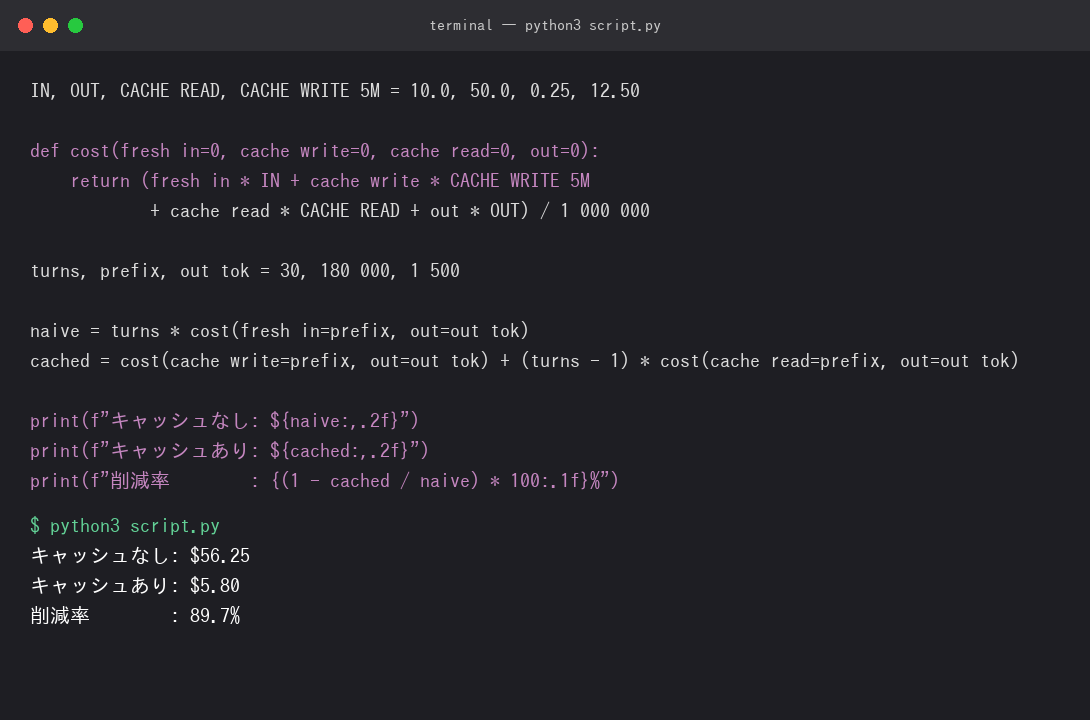
▲実際にこのブログの裏側で実行してみた結果です
実行すると、キャッシュなし $56.25 に対してキャッシュあり $5.80、削減率 89.7% になりました。もちろんこれは「毎ターン完全に同じプレフィックスが当たる」という理想条件なので、実際はキャッシュの5分TTLが切れたり会話履歴が伸びて再書き込みが走ったりで、ここまできれいにはいきません。ただ、キャッシュ設計をサボるかどうかで一桁変わりうる、というのは頭に入れておいたほうがよさそうです。
あと地味な注意点として、US内で処理させたい場合は US-only 推論が(inference_geo 指定で)入力・出力だけでなくキャッシュ書き込み/読み込みも含めて、トークン課金カテゴリ全体に1.1倍の倍率がかかります。データ所在地の要件がある案件だと効いてきそう。
Python での実装方法
基本は他の Claude モデルと同じで、モデルIDを差し替えるだけです。
from anthropic import Anthropic

client = Anthropic()

resp = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "medium"},
    messages=[
        {"role": "user", "content": "このログから根本原因を推定して"},
    ],
)
print(resp.content[-1].text)
違いは effort です。Fable 系は thinking を切れない代わりに、思考の深さを effort で調整する設計になっています。指定できるのは low / medium / high / xhigh / max の5段階で、デフォルトは high。Fable 5.1 は low や medium でも Fable 5 と同等かそれ以上のスコアが出て、高い effort ではさらに伸びるというのが Anthropic の主張です。なので「とりあえず全部 max」ではなく、まず medium あたりから試すのがコスパ的には正解なんだと思います。
ちなみに effort の渡し方は SDK やプラットフォームによって書き方が微妙に違うようです。Cloudflare Workers AI 経由だと output_config の中に effort、thinking に {"type": "adaptive"} を渡す形でした。SDK のバージョンによって変わりそうなので、実装前に一度公式ドキュメントを見たほうが安全です。
サンプリングパラメータの制約
ここ、知らないと普通に踏みます。Bedrock のモデルカードによると、以下の制約があります。
temperatureは 1.0 か未指定のみtop_pは 0.99 か未指定のみ- temperature と top_p の同時指定は不可
top_kは非対応
既存コードで temperature=0.2 みたいに書いていると、モデルIDを差し替えた瞬間にエラーになります。決定的な出力が欲しいときは温度ではなく structured outputs(JSON スキーマ指定)で縛る方向に考え方を切り替える必要がありそうです。Fable 5.1 は tool use と JSON スキーマによる構造化出力の両方に対応しています。
使う前に知っておきたい運用面の注意点
Fable 5.1 は「Covered Model」に指定されています。これは追加のデータ保持・安全性レビュー・アクセスポリシーが適用されるカテゴリで、要するに通常モデルより制約が強い。Covered Model を使うには、ワークスペース側でデータ保持(retention)を有効化する必要があるという扱いになっています。Zero Data Retention 前提の運用だと、そのままだと使えない(少なくとも両立しにくい)ケースが出てきます。
AWS と Anthropic が共同で Enterprise Frontier Safeguards(EFS)という仕組みを用意していて、対象顧客は retained monitoring data を自分でコントロールするクラウド環境内に置ける選択肢が出てきています。個人開発レベルだとあまり関係ない話ですが、業務で機密データを扱うなら確認必須のポイントだと思います。
もうひとつ、Fable 系には拒否されたリクエストを別モデルに逃がす fallbacks パラメータ(Claude API ではベータ)があります。出力が始まる前に拒否された場合は課金されず、別モデルで再試行するときはプロンプトキャッシュの切り替えコストが返ってくる「fallback credit」という仕組みもあるらしい。正直この辺はまだドキュメントを流し読みしただけで、実際に発火させたことがないので挙動の細かいところはわかっていません。
実際に使うかどうか
結論から言うと、常用はしないです。Anthropic 自身が「まずは Opus 5 を妥当なデフォルトに」と案内していて、長大なリポジトリ解析や難しいデバッグで Opus 5 が力尽きたときに Fable 5.1 を試す、という順番が推奨されています。分類や抽出みたいな軽いタスクなら Sonnet 5、もっと軽ければ Haiku 4.5 で十分。新しいからという理由で選ぶな、とはっきり書かれていて、これは耳が痛い。新しいモデルが出ると全部それに寄せたくなるタイプなので。
ただ、何年も原因不明だったクラッシュの真因を特定した、みたいな事例が出てくると、「詰まったとき用の切り札」として置いておく価値はありそうだなとは思います。1回数ドルで数日分の調査が終わるなら安い、という判断はありうる。
手元の小さめのリポジトリを丸ごと食わせて、effort を low から max まで振ってみて出力とコストがどう変わるか測ってみたいです。ただそれ、実験自体がそこそこ課金されるんですよね。Batch API の50%オフをうまく使えばいいのかなと考えているところです。
※この記事にはプロモーションが含まれます
そういえば、Claudeで議事録の要約プロンプトを組んでたら、そもそも録音自体をラクにできないかなと思って調べてたらPLAUD NOTE ってやつが気になってます。
まとめ
- Claude Fable 5.1 は最上位の frontier モデルで、thinking が常時オンで無効化できない
- 入出力単価は高いが、キャッシュ読み込みが $0.25 / 1Mトークンで異常に安い
- 理想条件ではコスト削減率 89.7% に到達、実務でも 25~45% 程度のコスト削減が見込める
- Python での実装は
output_config={"effort": "medium"} - サンプリングパラメータに制約がある(temperature と top_p の値が固定)
- 使用には Covered Model としてのデータ保持有効化が必要
- Opus 5 で足りなくなった場合の切り札として有効な選択肢