前回は fixture を紹介しました。@pytest.fixture で前後処理をまとめて、yield でティアダウン、conftest.py で共有、というあたりです。で、その続きを書こうとしてテストコードを眺めていたら、自分の書いたテストがこうなっていました。
def test_price_0():
    assert is_valid_price(0) is True

def test_price_100():
    assert is_valid_price(100) is True

def test_price_minus():
    assert is_valid_price(-1) is False
……コピペの嵐です。値だけ違うテストが縦に5個も6個も並んでいて、1個仕様が変わると全部直すことになる。これを一発で解決するのが @pytest.mark.parametrize でした。今回はそこをまとめます。
parametrize の基本形
使い方はシンプルで、デコレータに「引数名」と「値のリスト」を渡すだけです。リストの要素1個ごとに独立したテストとして実行されます。
import pytest


def is_valid_price(price):
    return isinstance(price, int) and 0 <= price <= 100000


@pytest.mark.parametrize("price", [0, 100, 100000])
def test_valid_prices(price):
    assert is_valid_price(price) is True


@pytest.mark.parametrize("price", [-1, 100001, "500", None])
def test_invalid_prices(price):
    assert is_valid_price(price) is False
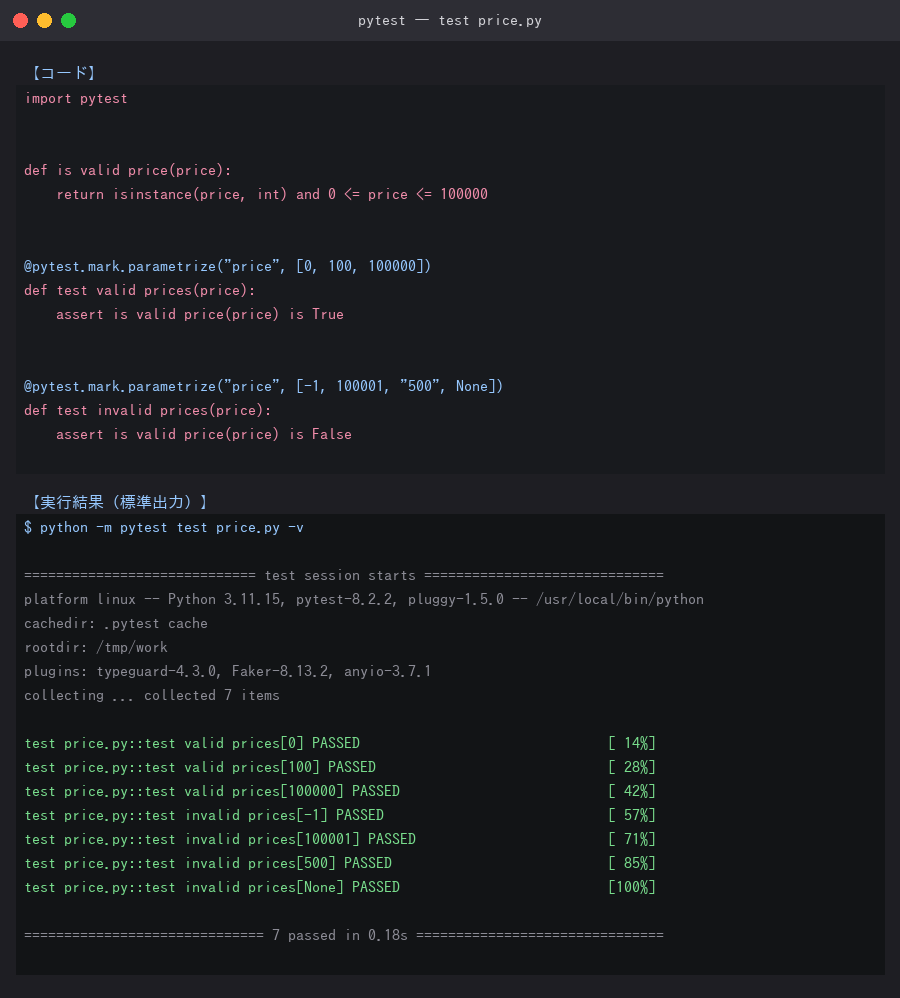
▲実際にこのブログの裏側で実行してみた結果です
これで7ケース分のテストになります。ここで大事なのは「for ループで回すのとは違う」ところで、ループだと1個目の assert で落ちた時点で残りが実行されませんが、parametrize は1ケースずつ別のテストとして扱われるので、どの値で落ちたのかが全部わかります。自分はこれを知ってからループでテストを書くのをやめました。
複数の引数をまとめて渡す
引数が複数あるときは、カンマ区切りの文字列と、タプルのリストで渡します。「入力→期待値」の表を書く感覚に近いです。
import pytest


def calc_fee(plan, amount):
    rates = {"free": 0.1, "pro": 0.05, "enterprise": 0.02}
    return int(amount * rates[plan])


@pytest.mark.parametrize(
    "plan, amount, expected",
    [
        ("free", 1000, 100),
        ("pro", 1000, 50),
        ("enterprise", 1000, 20),
        ("free", 0, 0),
    ],
)
def test_calc_fee(plan, amount, expected):
    assert calc_fee(plan, amount) == expected
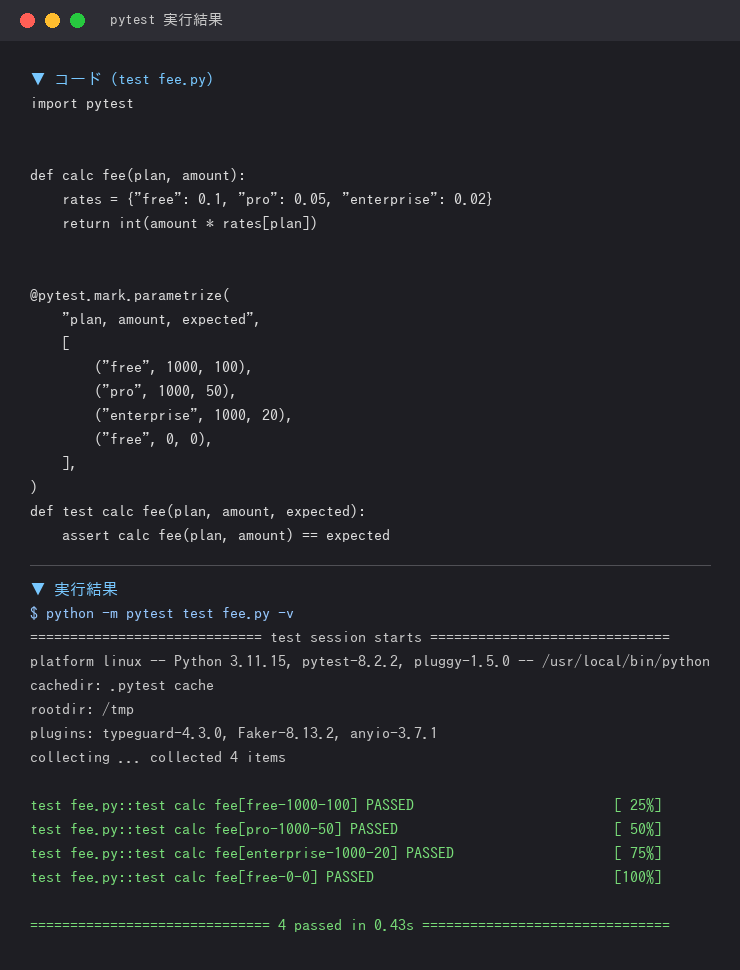
▲実際にこのブログの裏側で実行してみた結果です
"plan, amount, expected" はリスト形式(["plan", "amount", "expected"])でも書けます。自分は文字列派ですが、引数が増えてくるとリストのほうが diff が見やすい気もします。この辺は好みっぽいです。
あと、タプルの要素数と引数名の数が合っていないと収集時にエラーになります。ケースを追加するときにカンマを1個落としてハマったことがあるので、そこは注意ポイントかなと。
ids でテスト名を読みやすくする
parametrize したテストは test_calc_fee[free-1000-100] のように、値から自動でIDが作られることが多いです。数値や文字列なら十分読めるんですが、dict やオブジェクトを渡すと test_foo[plan0] みたいな味気ない名前になってしまうことがあります。
そこで pytest.param で個別にIDを付けられます。ついでに、このケースだけ xfail にする、みたいなマーカーも付けられます。
import pytest


def calc_fee(plan, amount):
    rates = {"free": 0.1, "pro": 0.05, "enterprise": 0.02}
    return int(amount * rates[plan])


@pytest.mark.parametrize(
    "plan, amount, expected",
    [
        pytest.param("free", 1000, 100, id="free-1000yen"),
        pytest.param("pro", 1000, 50, id="pro-1000yen"),
        pytest.param(
            "ghost", 1000, 0,
            id="unknown-plan",
            marks=pytest.mark.xfail(raises=KeyError),  # 未対応プランは今は落ちる
        ),
    ],
)
def test_calc_fee_with_ids(plan, amount, expected):
    assert calc_fee(plan, amount) == expected
実行すると最後のケースだけ XFAIL になります。「仕様として直したいけど今は落ちる」ケースを、コメントアウトせずにテストの中に残しておけるのが個人的にはかなり気に入っています。コメントアウトすると、だいたいそのまま忘れるので……。
ids= にリストや関数を渡してまとめて命名する方法もあります。ただ、ケースごとに pytest.param で書いたほうが後から追いやすい気がして、自分はそっちに寄せています。
parametrize を重ねると組み合わせが全部走る
デコレータは複数重ねられます。その場合、値の直積(全組み合わせ)が実行されます。
import pytest


@pytest.mark.parametrize("lang", ["ja", "en"])
@pytest.mark.parametrize("plan", ["free", "pro"])
def test_combination(plan, lang):
    assert (plan, lang) in [
        ("free", "ja"), ("free", "en"), ("pro", "ja"), ("pro", "en"),
    ]
2 × 2 で4ケース。便利なんですが、これは油断すると爆発します。3つ重ねて各5値にすると125ケース。1ケース 0.5 秒かかるテストだと1分超えます。CI が遅くなってきたときに --collect-only でケース数を数えてみると、だいたいこういうのが原因だったりします。
全組み合わせが本当に必要なのか、代表的な組み合わせだけタプルで列挙すれば済むのか。ここは毎回ちょっと悩みます。正直、まだ自分の中で明確な基準は持てていません。
fixture と組み合わせる(indirect と params)
前回の fixture と絡めると、もう一段おもしろくなります。parametrize の値を「テスト関数」ではなく「fixture」に渡したいときは indirect=True を使います。値は fixture 側で request.param として受け取ります。
import pytest


@pytest.fixture
def user(request):
    plan = request.param  # ここに parametrize の値が飛んでくる
    return {"name": "ニャンチュー", "plan": plan, "limit": 10 if plan == "free" else 1000}


@pytest.mark.parametrize("user", ["free", "pro"], indirect=True)
def test_user_limit(user):
    assert user["limit"] > 0


@pytest.fixture(params=["sqlite", "postgres"])
def db(request):
    return {"engine": request.param}


def test_db_engine(db):
    assert db["engine"] in ("sqlite", "postgres")
後半の @pytest.fixture(params=[...]) のほうは、fixture 自体をパラメータ化するやり方です。この場合、その fixture を使っているテストが自動的に全パラメータ分ぶん増えます。「SQLite と PostgreSQL の両方で全テストを回したい」みたいなケースだと、テスト側に一切手を入れなくて済むので強力です。強力すぎて、知らずに使うとテスト数が倍になって驚きます。
ちなみに indirect 周りは実装がわりと複雑なようで、パラメータ化された fixture(@pytest.fixture(params=[...]))を indirect な parametrize(@pytest.mark.parametrize(..., indirect=True))で上書きすると失敗する回帰が pytest 9.1.0 で入って、その後の pytest 9.1.1 で修正されています。込み入った使い方をするときは pytest 自体のバージョンも見ておいたほうがいいかもしれません。
2026年の pytest まわりを軽く
いま(2026年9月時点)の最新は pytest 9.1.1 で、メジャーの 9.0 では subtests のコア取り込みや、TOML 設定ファイル(pytest.toml)の標準対応などが入りました。あと「strict モード」系の変更も入っているようです。
subtests は「1つのテスト関数の中で複数のチェックを独立して報告する」仕組みなので、用途が parametrize とちょっと重なります。自分の現状の整理は、入力パターンを表として並べたいなら parametrize、ループの中の1ステップずつを報告したいなら subtests、くらいのゆるい感じです。ここはもっといい切り分けがあると思うので、実際に使いながら考えたいところ。
余談ですが、設定を pytest.toml に書けるようになったのは地味に嬉しくて、setup.cfg のあの独特なインデントから解放されました。
今回のまとめ
parametrize は「テストを短く書くための機能」というより、「どの入力で壊れたかを機械に教えてもらうための機能」だと思うようになりました。コピペしたテストを1個の parametrize にまとめるだけで、ケース追加が1行で済むようになるのも普通に気持ちいいです。
マーカーとオプションまわり、-k や -m での絞り込み、それと GitHub Actions で回す話も絡めると、テスト数が増えたときの運用が一気にやりやすくなる印象があります。テスト数が増えるとローカルで全部回すのがしんどくなるので、そのあたりの折り合いをどう付けているか、みなさんどうしてるんでしょうね。
※この記事にはプロモーションが含まれます
余談ですが、pytestでテストコード書いてたら急に自分のブログ環境も整えたくなって、お名前.com レンタルサーバー をちょっと調べてました。
📚 シリーズ「Python pytest 入門」(第3回 / 全4回)
← 前回の記事: 前回の記事はこちら
→ 次回の記事: 【第4回】Python pytest 入門 — テスト設計のベストプラクティスとよくある落とし穴・応用Tips