※この記事にはプロモーションが含まれます
普段はClaude APIでツール呼び出しを書くことが多いんですが、OpenAI側の「Agents SDK」が最近どこまで進んでいるのか気になって、Pythonでの使い方を一通り調べてみました。調べたことを自分用にまとめたメモです。
この記事でわかること
- OpenAI Agents SDKの概要と、2026年11月時点のバージョンまわりの状況
- インストールして最初のエージェントを動かすまでの手順
- Function Tool・Handoff・ガードレールの書き方
- Sessions(会話履歴)とMCPサーバー連携の基本
- 関数がツールのスキーマに変わるときの仕組み(標準ライブラリだけで再現)
OpenAI Agents SDKとは?2026年11月時点の立ち位置
OpenAI Agents SDKは、OpenAIが公開している(軽量なフレームワークとして紹介されている)エージェント向けのSDKです。2025年3月に、実験的なSDKとして公開されていた「Swarm」より改善された形で発表されています。PyPIのパッケージ名は openai-agents で、ライセンスはMIT。TypeScript版も @openai/agents として公開されています。
中心になる考え方はすごくシンプルで、だいたい次の4つを押さえればいいっぽいです。
- Agent:instructions(システムプロンプト)とツールを持ったLLM
- Tools:Pythonの関数をそのままツールにできる
- Handoffs:別のエージェントに会話を引き継ぐ仕組み
- Guardrails:入出力をチェックして、ダメなら止める仕組み
あとはこれを Runner が回してくれます。「ツールを呼ぶ → 結果をLLMに返す → また考える」のループを自前で書かなくていいのが一番うれしいところかなと思います。トレーシングも最初から組み込まれていて、OpenAI側の機能(ダッシュボード等)で追えるように作られています。
バージョンはまだ1.0未満の0.2x系で、リリースはかなり頻繁です。執筆時点ではPyPI上で0.22系(例:0.22.3)が確認できました。一方で、別経路としてGitHub Releases側に0.24.0-alphaのような”PyPIとは別配布っぽい”リリースも見えるので、見ている場所で「今の最新」がズレやすいところは注意かなと思います。最近の変更で気になったものをメモしておきます。
- 0.14.0:Sandbox Agentsが追加。隔離されたワークスペースでファイル操作やコマンド実行ができるエージェントで、ローカル用の
UnixLocalSandboxClient、DockerSandboxClient、それからCloudflare・Vercel・E2B・Modal・Daytonaなどのホスト型クライアントにも(optional extras経由で)対応 - 0.21.0:
openai>=3.0.0,<4(OpenAI Python SDK v3系)に対応。あと、実際にAPIを呼ばずにエージェントの動作をテストできるagents.testingなどのユーティリティが追加
デフォルトモデルがバージョンによって変わる可能性があるので、本番っぽい用途なら model= を明示しておいたほうが安心かもしれません。それと、公式の周辺ドキュメントを見る限り、Responses APIやChat Completions APIを含む形でいろいろな"モデル供給元"に繋げられる設計になっていそうで、このへんは自分も引き続き確認したいポイントです。
インストールと最初のエージェント
Python 3.10以上が必要です。公式のクイックスタートでもpipとuvの両方が載っています。自分はuvを使ったことがあるので、uvで入れる場合はこんな感じです。
uv init agents-sandbox
cd agents-sandbox
uv add openai-agents
export OPENAI_API_KEY=sk-...
pipなら pip install openai-agents だけです。音声を使うなら openai-agents[voice]、Redisでセッションを持つなら openai-agents[redis] のように、追加機能はextrasで入れる形になっています。
Hello Worldはこれだけです。
from agents import Agent, Runner

agent = Agent(
    name="Assistant",
    instructions="あなたはAWSに詳しいアシスタントです。簡潔に答えてください。",
)

result = Runner.run_sync(agent, "Lambdaのコールドスタートを短く説明して")
print(result.final_output)
Runner.run_sync は同期版で、公式ドキュメントでも同期実行の手段として説明されています。ちょっと試すだけなら同期版でも問題なさそうですが、環境によっては(Jupyterみたいに)イベントループまわりでハマることもあるので、その場合は await Runner.run(...) 側を使うのがよさそうです。
ツール・Handoff・ガードレールの使い方
Function Tool
Pythonの関数に @function_tool を付けると、それだけでツールになります。型ヒントとdocstringからスキーマを自動で作ってくれるような作りになっていて、引数のバリデーションも何らかの仕組みで行われるようです。
from pydantic import BaseModel
from agents import Agent, Runner, function_tool


@function_tool
def get_monthly_cost(service: str) -> str:
    """指定したAWSサービスの今月のコストを返す"""
    dummy = {"Lambda": 0.42, "S3": 1.10, "DynamoDB": 0.08}
    return f"{service}: ${dummy.get(service, 0)}"


class CostReport(BaseModel):
    total_usd: float
    comment: str


agent = Agent(
    name="Cost Checker",
    instructions="ツールでコストを調べてレポートしてください。",
    tools=[get_monthly_cost],
    output_type=CostReport,
)

result = Runner.run_sync(agent, "LambdaとS3のコストを合計して")
print(result.final_output)  # CostReport型で返ってくる
output_type にPydanticモデルを渡すと、構造化出力として受け取れます。後続の処理につなぐならほぼ必須かなと思います。
実装寄りの話をひとつ。0.8.0から、同期関数のツールはイベントループのスレッドではなく asyncio.to_thread() でワーカースレッド上で動くようになっています。スレッドローカルな状態に依存するコード(古めのDBクライアントとか)をツールにする場合は、asyncで書き直すか、スレッドの扱いをはっきりさせておく必要があるらしいです。
「関数からスキーマを作る」ところが何をしているのか気になったので、標準ライブラリだけで雑に真似してみました。本物はもっとちゃんとやっていますが、イメージをつかむには十分かなと。
import inspect
import json
from typing import get_type_hints

TYPE_MAP = {str: "string", int: "integer", float: "number", bool: "boolean"}


def to_tool_schema(func):
    hints = get_type_hints(func)
    hints.pop("return", None)
    sig = inspect.signature(func)
    props = {name: {"type": TYPE_MAP.get(tp, "string")} for name, tp in hints.items()}
    required = [n for n, p in sig.parameters.items() if p.default is inspect.Parameter.empty]
    return {
        "name": func.__name__,
        "description": inspect.getdoc(func),
        "parameters": {"type": "object", "properties": props, "required": required},
    }


def get_weather(city: str, days: int = 1) -> str:
    """指定した都市の天気予報を返す"""
    return f"{city}: 晴れ"


print(json.dumps(to_tool_schema(get_weather), ensure_ascii=False, indent=2))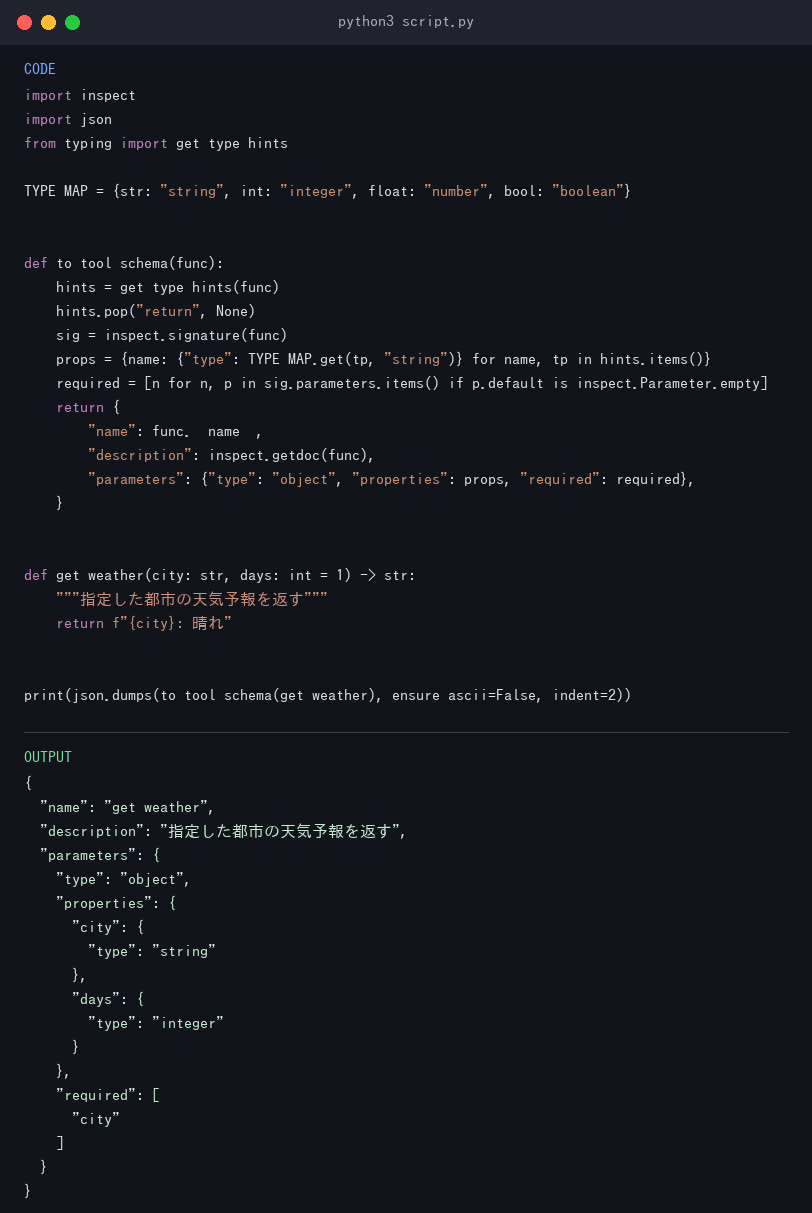
▲実際にこのブログの裏側で実行してみた結果です
デフォルト値のない city だけが required に入ります。つまりdocstringがそのままLLMに渡る説明文になるので、ツールのdocstringは手を抜かないほうがいいということですね。
Handoffと「Agents as tools」
複数エージェントの連携には2つのやり方があります。
from agents import Agent, Runner

billing_agent = Agent(name="Billing", instructions="請求・コストの質問に答える")
infra_agent = Agent(name="Infra", instructions="インフラ構成の質問に答える")

# パターン1: handoff(会話ごと引き継ぐ)
triage = Agent(
    name="Triage",
    instructions="質問の内容に応じて適切な担当に引き継いでください。",
    handoffs=[billing_agent, infra_agent],
)

# パターン2: ツールとして呼ぶ(司令塔に結果が戻ってくる)
manager = Agent(
    name="Manager",
    instructions="必要に応じて専門家に聞き、最終回答は自分でまとめてください。",
    tools=[
        billing_agent.as_tool(tool_name="ask_billing", tool_description="コストについて聞く"),
        infra_agent.as_tool(tool_name="ask_infra", tool_description="構成について聞く"),
    ],
)

result = Runner.run_sync(triage, "先月のS3の請求が高い理由は?")
print(result.last_agent.name, result.final_output)handoffは「担当者に電話を回す」感じで、それ以降は引き継いだ先のエージェントが答えます。as_tool は「司令塔が専門家に聞いて、回答は自分でまとめる」感じです。どっちを選ぶかは、最終回答の口調や形式を揃えたいかどうかで決めればいいのかなと。正直、複雑なワークフローでどっちが安定するかはまだよくわかっていません。
ガードレール
入力をチェックして、条件に当てはまったら処理を止める仕組みです。チェック役に小さいエージェントを使うのが定番っぽいです。
from pydantic import BaseModel
from agents import (
    Agent, Runner, GuardrailFunctionOutput,
    InputGuardrailTripwireTriggered, input_guardrail,
)


class TopicCheck(BaseModel):
    is_off_topic: bool
    reason: str


checker = Agent(
    name="Checker",
    instructions="入力がAWSやクラウドに関係なければ is_off_topic を true にしてください。",
    output_type=TopicCheck,
)


@input_guardrail
async def aws_only(ctx, agent, user_input):
    r = await Runner.run(checker, user_input, context=ctx.context)
    return GuardrailFunctionOutput(
        output_info=r.final_output,
        tripwire_triggered=r.final_output.is_off_topic,
    )


agent = Agent(name="AWS相談役", instructions="AWSの質問に答える", input_guardrails=[aws_only])

try:
    Runner.run_sync(agent, "今日の夕飯なにがいいと思う?")
except InputGuardrailTripwireTriggered:
print("AWSの質問でお願いします…")公式の説明では、ガードレールはエージェント本体と並列で実行されて、引っかかったらすぐ止まる設計になっています。レスポンスは速くなりますが、そのぶん止まるまでに本体側でトークンを消費することもあるはずなので、コストを気にするなら設定を確認しておいたほうがよさそうです。
Sessions(会話履歴)とMCP連携
Sessionsで会話を覚えさせる
何もしないと、Runner.run は1回ごとに独立しています。会話を続けたいときは、Sessionを渡せば履歴を自動で出し入れしてくれます。
from agents import Agent, Runner, SQLiteSession

agent = Agent(name="Assistant", instructions="親しみやすく答える")
session = SQLiteSession("user_123", "conversations.db")

Runner.run_sync(agent, "自分の名前はニャンチューです", session=session)
result = Runner.run_sync(agent, "自分の名前、覚えてる?", session=session)
print(result.final_output)
SQLiteのほかにRedis用のextrasもあって、ドキュメントには AdvancedSQLiteSession という名前も出てきます。個人的には、DynamoDBをバックエンドにしたSessionを自作したらLambdaと相性がよさそう…と思ってるんですが、まだ妄想の段階です。
MCPサーバーをつなぐ
最近ずっと気になっているMCPにも対応しています。ローカルのMCPサーバーをstdioで起動してつなぐ場合は、だいたいこんな形になるようです(※ここは自分が見つけた範囲だと、クラス名やAPIがバージョンで変わる可能性があるので、手元のSDKのドキュメントと突き合わせ推奨です)。
import asyncio
from agents import Agent, Runner
from agents.mcp import MCPServerStdio


async def main():
    async with MCPServerStdio(
        name="filesystem",
        params={
            "command": "npx",
            "args": ["-y", "@modelcontextprotocol/server-filesystem", "./docs"],
        },
    ) as server:  # async with を忘れると接続されない。ここ注意
        agent = Agent(
            name="Docs Helper",
            instructions="docsフォルダの中身を調べて答える",
            mcp_servers=[server],
        )
        result = await Runner.run(agent, "docsにあるファイルを一覧にして")
        print(result.final_output)


asyncio.run(main())
リモートのMCPサーバー向けにHTTP系のクライアントも用意されているようです。また、0.8.0前後でMCPまわりの挙動もいろいろ調整されているようなので、失敗時の扱い(落とす/落とさない、エラーをモデルに見せる等)は、使っているバージョンのリリースノートを見ておくのがよさそうです。
余談ですが、Claude CodeやCodexみたいなコーディングエージェントを触ったあとでこのSDKを見ると、「あれの中身ってこういう部品の組み合わせなんだな」というのがなんとなく見えてきて面白いです。0.14.0で入ったSandbox Agentsなんかは、まさにそっち方向の機能ですね。
まとめ
OpenAI Agents SDKは、Agent・Tools・Handoffs・Guardrailsの4つを押さえれば基本はだいたい書けるくらい、抽象化が薄めのSDKでした。そのぶんPythonの普通の書き方で組めるので、LangChain系の独自の概念に疲れた人にも合いそうです。一方で0.x系でリリースがとにかく速いので、モデルの指定やバージョンの固定はちゃんとやっておいたほうがよさそうです。
3か月ほど放置しているLambdaの日次AWSコスト集計を、このSDKのエージェントに「先週と比べてどう?」と聞ける形にしてみたいなと思っています。