※この記事にはプロモーションが含まれます
シリーズ最終回です。前回までで、Pythonから GPT-6 Astra API を呼び出して、いろいろな機能を試すところまで紹介しました。今回は「動いた!」の次の段階、本番っぽい環境で動かし続けるために必要なことをまとめます。エラーハンドリングとお金の話、それと引っかかりやすいポイントです。
正直、自分みたいな個人開発レベルだと「本番運用」は少し大げさかもしれません。それでも Astra は単価が高いモデルだと言われているので、雑に組むと請求額で泣くことになりそうです。最初から気をつけておくほうが良さそうだと思いました。
この記事でわかること
- GPT-6 Astra API で起きるエラーの種類と、リトライしていいもの・いけないものの見分け方
- OpenAI SDK の組み込みリトライと自前リトライが重なる問題
- reasoning effort・プロンプトキャッシュ・Fast mode とコストの関係
- Lambda で動かすときのタイムアウトまわりの注意点
- Astra ならではの落とし穴(effort の none 非対応、安全分類器による拒否など)
まずはエラーの種類を整理する
エラーハンドリングで最初にやるべきなのは、エラーを「待てば直るもの」と「何回やっても直らないもの」に分けることだと思っています。ここが混ざると、400エラーを延々リトライしてログが埋まります。
- リトライしていい:429(レート制限)、500系(サーバー側エラー)、タイムアウト、接続エラー
- リトライしても無駄:400(パラメータ不正)、401(認証)、403(権限)、404(モデル名の打ち間違いなど)
- グレー:429 のうちクォータ切れ(insufficient_quota)。レート制限と同じ429で返ってくることがある一方で、待っても直らないケースもあるようです。請求設定を見直すしかないです
OpenAI の Python SDK は、これらを例外クラスで分けてくれています。Responses API で Astra を呼ぶなら、だいたいこんな形になると思います。
import logging
import openai
from openai import OpenAI

logger = logging.getLogger(__name__)
client = OpenAI(max_retries=3, timeout=180.0)


def ask(prompt: str, effort: str = "medium") -> str | None:
    try:
        resp = client.responses.create(
            model="gpt-6-astra",
            reasoning={"effort": effort},
            input=prompt,
            max_output_tokens=8000,
        )
    except openai.RateLimitError as e:
        if getattr(e, "code", None) == "insufficient_quota":
            logger.error("クォータ切れ。リトライしても無駄")
        else:
            logger.warning("レート制限(SDKのリトライも尽きた): %s", e)
        return None
    except (openai.APITimeoutError, openai.APIConnectionError) as e:
        logger.warning("通信系エラー: %s", e)
        return None
    except openai.BadRequestError as e:
        logger.error("リクエスト不正。コードを直す: %s", e)
        raise
    except openai.AuthenticationError:
        logger.critical("APIキーを確認")
        raise
    except openai.APIStatusError as e:
        logger.error("その他のHTTPエラー status=%s", e.status_code)
        return None

    if resp.status == "incomplete":
        # ここ注意: 例外は出ないのに中身が途中で切れている
        logger.warning("incomplete: %s", resp.incomplete_details.reason)

    return resp.output_text
ポイントは最後の status == "incomplete" のところです。トークン上限などの理由で出力が途中で止まった場合、例外にならずに普通にレスポンスが返ってくるケースがあります。try/except だけ書いて安心していると、「エラーは出てないのに結果が空っぽ」という状態に気づけません。Astra は推論トークンをたくさん使う場面があるので、このチェックはわりと大事だと思っています。
BadRequestError を raise しているのは、これがコードのバグである可能性が高いからです。握りつぶして None を返すと、原因の調査が大変になります。ここは好みが分かれそうなので、もっといい書き方があるかもしれません。
リトライは「二重」にしない
これは調べていて「あー、やりそう…」と思ったポイントです。OpenAI の Python SDK は、デフォルトで接続エラー・429・500系などを自動でリトライしてくれます(デフォルトは2回)。ここに tenacity などで自前のリトライを重ねると、回数が掛け算になります。自前で5回 × SDKで3回なら、最悪15リクエストです。
レート制限で429が返ってるときにこれをやると、制限をさらに悪化させるリトライストームになりかねません。なので方針はどちらかに寄せるのが良さそうです。
- SDK に任せる:
OpenAI(max_retries=3)だけ設定して自前リトライは書かない - 自前で制御する:
OpenAI(max_retries=0)にして、自分でバックオフを書く
自前でやる場合の考え方を、SDK なしで動くシミュレーションにしてみました。指数バックオフに「フルジッター」(待ち時間を0〜上限の範囲でランダムにする)を足したものです。複数のワーカーが同時に429を食らっても、一斉に再送しないようにするための工夫です。
import random
import time


class RateLimitError(Exception):
    pass


class BadRequestError(Exception):
    pass


RETRYABLE = (RateLimitError, TimeoutError, ConnectionError)


def call_with_retry(func, max_attempts=5, base=0.1, cap=2.0):
    for attempt in range(1, max_attempts + 1):
        try:
            return func()
        except RETRYABLE as e:
            if attempt == max_attempts:
                raise
            wait = random.uniform(0, min(cap, base * 2 ** attempt))  # full jitter
            print(f"  attempt {attempt}: {type(e).__name__} -> {wait:.2f}s 待って再試行")
            time.sleep(wait)


random.seed(4)


def flaky():
    r = random.random()
    if r < 0.5:
        raise RateLimitError("429")
    if r < 0.6:
        raise TimeoutError("timeout")
    return "ok!"


def broken():
    raise BadRequestError("400: invalid parameter")


print("flaky:", call_with_retry(flaky))
try:
    call_with_retry(broken)
except BadRequestError as e:
    print("broken: リトライせず即失敗 ->", e)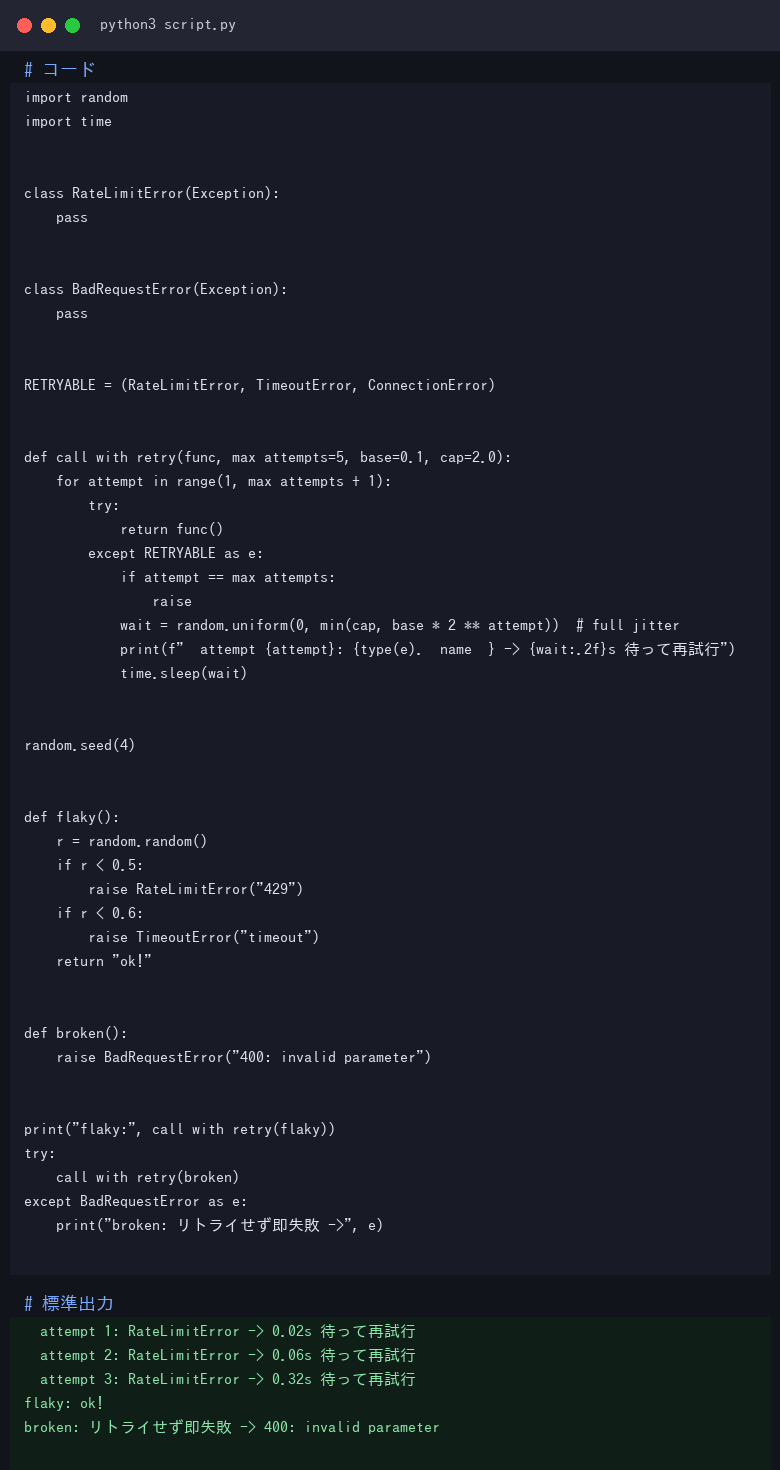
▲実際にこのブログの裏側で実行してみた結果です
実行すると、flaky のほうは429を3回食らったあとに成功します。broken のほうは BadRequestError がリトライ対象のタプルに入っていないので、1回目で即失敗します。本番ではここに「429のレスポンスに retry-after ヘッダーがあればその秒数を優先する」という処理を足すと、より行儀がいいと思います。
Lambda で動かすときのタイムアウト
自分は AWS 寄りの人間なので、Lambda から呼ぶ前提でも考えてみました。Lambda のタイムアウトはデフォルト3秒、最大15分です。Astra を high や max の effort で動かすと返事に時間がかかることがあるので、デフォルトのままだとまず間に合いません。
注意したいのは、各層のタイムアウトの関係です。
- SDK の timeout × リトライ回数 が Lambda のタイムアウトを超えると、リトライの途中で Lambda ごと強制終了される
- SQS トリガーにする場合、可視性タイムアウトは Lambda のタイムアウトより長くしておかないと、処理中のメッセージがもう一度配信されて二重課金になることがあります
二重課金のほうが地味に怖いです。普通の API なら二重実行してもそこまで痛くありません。でも Astra の max effort を二重に回すと、普通に財布へのダメージになります。長考系のタスクは、Lambda より ECS や Step Functions に逃がしたほうがいいのかもしれません。ここはまだ自分の中で結論が出ていません。
コスト最適化:effort とトークンの関係を把握する
API 料金は、Standard で入力が$10/百万トークン、出力が$50/百万トークンという設定になっています。GPT-6.1 Sol と比べてもかなり高い部類だと言われているので、「とりあえず全部 Astra で」はやめたほうが良さそうです。
気をつけたいのは、推論(reasoning)トークンが usage で見えることです。effort を上げるほど裏で考えるトークンが増えやすいので、表に出てくる回答が短くても請求は膨らみます。ざっくり感覚をつかむために、計算スクリプトを書いてみました。トークン数は適当に置いた仮定の値です。
INPUT_PRICE = 10.0
OUTPUT_PRICE = 50.0


def estimate_cost(input_tokens, output_tokens, fast=False):
    # ここ注意: 推論トークンは output_tokens 側に含めて計算する
    cost = input_tokens / 1_000_000 * INPUT_PRICE + output_tokens / 1_000_000 * OUTPUT_PRICE
    if fast:
        cost *= 2
    return cost


cases = [
    ("low・短い回答", 3_000, 800, 200),
    ("high・長考", 3_000, 9_000, 7_500),
    ("max・長文コンテキスト", 200_000, 30_000, 25_000),
]

for name, inp, out, rea in cases:
    c = estimate_cost(inp, out)
    print(f"{name:<14} 1回 ${c:.4f} / 1日1000回 ${c * 1000:,.2f} (うち推論 {rea / out:.0%})")

print(f"Fast mode にすると high のケースは 1回 ${estimate_cost(3_000, 9_000, fast=True):.4f}")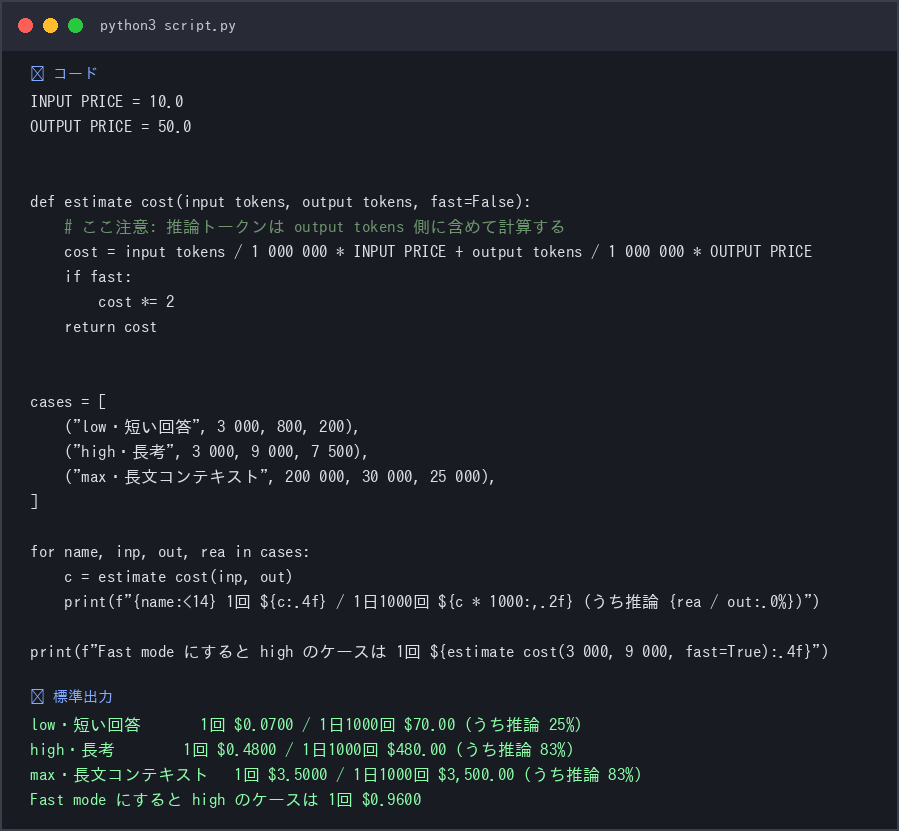
▲実際にこのブログの裏側で実行してみた結果です
仮定の数字ではありますが、low で1回$0.07のものが、長文コンテキスト+max になると1回$3.5まで跳ねます。1日1000回なら$3,500です。しかも high 以上のケースでは、出力の8割以上が推論トークンという計算になります。数字を並べてみて、ちょっと背筋が伸びました。
コストを抑えるために、今のところ考えている作戦はこのあたりです。
- effort をタスクで使い分ける:分類や要約は low、設計レビューのような難しいものだけ high 以上にする。Astra は low / medium / high / xhigh / max の5段階です
- 簡単なタスクはそもそも Sol 系に回す:ルーター的な関数を1枚かませて、モデルを振り分ける
- プロンプトキャッシュを効かせる:システムプロンプトや固定のドキュメントなど、変わらない部分をプロンプトの先頭に寄せる。毎回変わる部分を前に置くとキャッシュが効きにくいらしいです
- max_output_tokens を設定する:暴走したときの上限になります。ただし小さすぎると後述の incomplete 問題が起きる
- Fast mode は本当に必要なときだけ:料金は2倍です
あと、Astra のコンテキストウィンドウは約105万トークンあるそうです。「全部突っ込めばいいじゃん」という誘惑がありますが、入力も当然課金されます。RAG で必要な部分だけ渡すほうが、結局は安くて精度も安定しそうです。
使用量はレスポンスから必ず記録する
レスポンスの usage には、入力・出力のほかに、キャッシュされた入力トークン数や推論トークン数も入っています。これを毎回ログに残しておくと、「どの機能がお金を食っているか」が後から追えます。
def log_usage(resp, feature: str):
    u = resp.usage
    record = {
        "feature": feature,
        "model": resp.model,
        "input": u.input_tokens,
        "cached": u.input_tokens_details.cached_tokens,
        "output": u.output_tokens,
        "reasoning": u.output_tokens_details.reasoning_tokens,
    }
    logger.info("usage %s", record)
    return record
ここで記録したものを DynamoDB に溜めて日次で集計すれば、ダッシュボードっぽいものが作れるはずです。そういえば自分は Lambda で AWS の日次コストを集計して Web ページに出すところまで作ったものの、表示部分を3か月ほど放置しています。仕組みは作っても見なければ意味がない、という良い反面教師です。予算アラートのような「向こうから知らせてくれる仕組み」を必ずセットにしたほうがいいですね。
Astra ならではのよくある落とし穴
最後に、公式ドキュメントや各所の情報を読んでいて「これは引っかかりそう」と思ったものを並べておきます。
1. effort の none が使えない
公式のガイドには、GPT-6 Astra は reasoning effort の none に対応していないと書かれています。旧モデル向けに「速さ優先で none」としていたコードを、モデル名だけ差し替えて流用すると、パラメータ不正のエラーになりそうです。前の章の分類で言うと、リトライしても絶対に直らない側です。
2. Responses API と Chat Completions で effort の渡し方が違う
Responses API では reasoning={"effort": "low"} とネストしたオブジェクトで渡し、Chat Completions では reasoning_effort="low" とフラットな文字列で渡すそうです。両方のエンドポイントを使っているプロジェクトだと混ざりやすいので、ラッパー関数を1つ作って吸収するのがおすすめです。
3. 出力が空っぽ(incomplete)
max_output_tokens を小さめにしていると、推論トークンだけで上限を使い切ってしまうことがあります。その結果、回答本文がほぼ空のまま返ってきます。例外にならないので気づきにくいです。resp.status と incomplete_details.reason をチェックして、上限に達していたら上限を上げて再実行するか、effort を下げて再実行する、という分岐を入れておくと安心です。
4. 安全分類器による拒否はエラーではない
Astra はセキュリティ関連で評価を受けたモデルのため、セキュリティや生物・化学系のリクエストは安全分類器で拒否されることがあります。組織によっては Trusted Access プログラムに対応している場合もあります。拒否は「正常なレスポンスとして断られる」形になるはずなので、リトライしても結果は変わりません。脆弱性スキャン結果の要約みたいな用途を考えている場合は、拒否されたときの代替フローを用意しておいたほうが良さそうです。
5. 日付付きスナップショットがまだ無い
モデルIDは gpt-6-astra で、執筆時点では日付付きのスナップショットはまだ用意されていないという情報があります。ということは、同じIDのまま中身が更新される可能性があります。挙動が急に変わったときに追えるよう、レスポンスの model をログに残しておくのが地味に効くと思います。
6. Fast mode と EU データレジデンシー
これは日本の個人開発ではあまり関係ないかもしれません。ただ、EU データレジデンシーを使っている環境では Fast mode が使えないそうです。会社のプロジェクトで「本番だけ使えない」となると切り分けが面倒なので、頭の片隅に置いておきたいです。
余談ですが、Astra は Amazon Bedrock からも使えるそうなので、AWS 勢としてはそっちの経路も気になっています。Bedrock 経由だとエラーの型が boto3 側の例外になるはずです。今回のような例外クラスでの分岐はそのままでは使えません。このあたりは比べてみる価値がありそうです。
まとめ
- エラーは「待てば直る(429・500系・タイムアウト)」と「直らない(400・401・クォータ切れ)」に分けて扱う
- SDK の組み込みリトライと自前リトライを重ねない
- 例外が出なくても
status == "incomplete"と安全分類器による拒否はチェックする - 推論トークンは usage で見えるので、effort の使い分けとモデルの振り分けがコスト最適化の本命
- usage と model は毎回ログに残して、予算アラートとセットにする