※この記事にはプロモーションが含まれます
会社のSlackボットをGPT-5.6 Sol から gpt-6-astra に差し替えようとしたら、ツール呼び出しのところがまるっと動かなくなって半日溶かしました。原因は単純だったんですが、その過程で「Astra世代のAPIは思ってたより別物だな」と感じたので、せっかくなので、つまずいたツール呼び出しの部分を中心にまとめてみることにしました。
自分も初学者なので、「公式ドキュメント読みながら手を動かしたメモ」くらいの温度感で読んでもらえると。
この記事でわかること
- GPT-6 Astra のモデルスペックと料金の勘どころ
- Python SDK のセットアップ(最短の手順)
- なぜツール呼び出しが Responses API 前提になったのか
- 関数ツールの定義 → 呼び出し → 結果返却の2ターン往復の書き方
- GPT-5.6 から移行するときにハマりやすいポイント
GPT-6 Astra のスペックをざっくり把握する
まず前提の整理から。GPT-6 Astra は OpenAI の最新フラッグシップモデルで、API のモデルIDは gpt-6-astra、入力100万トークンあたり$10・出力$50、コンテキストウィンドウは1,050,000トークンです。最大出力は128,000トークン、推論エフォートは low / medium / high / xhigh / max の5段階になっています。
料金で見落としがちなのが長文時の段差で、272Kトークンを超えるプロンプトは入力・キャッシュが2倍、出力が1.5倍のレートでリクエスト全体に課金されるとのこと。1Mコンテキストだ!と喜んで全部突っ込むと請求が跳ねるやつですね。キャッシュ読み取りは$1まで下がるので、実運用ではキャッシュ前提の設計になりそうです。
あと地味に重要なのが、reasoning.effort が none を受け付けなくなった点、temperature / top_p / logprobs が非対応とされている点、そしてツール呼び出しが Responses API を要求する点です。自分が半日溶かしたのはまさにこれで、gpt-5.6-sol で動いていたコードが gpt-6-astra だと「本番に出るまで気づきにくい形で」壊れるという指摘、身をもって体験しました……。
環境構築(最短の手順)
Python 3.11 + uv で進めます。pip でも問題ないです。
uv init astra-tutorial
cd astra-tutorial
uv add openai
export OPENAI_API_KEY="sk-..."
APIキーの設定や最初のリクエストの送り方、Astra で使えないパラメータは「GPT-6 Astra APIのPython入門|旧コードが通らない理由」で詳しくまとめています。この記事では、すぐにツール呼び出しに進みます。
なぜツール呼び出しは Responses API なのか
Astra 世代ではツール関連の機能が Responses API に集約されていて、Responses API 側には Web検索・ファイル検索・画像生成・コードインタプリタ・hosted shell・Apply Patch・computer use・MCP・tool search といった組み込みツールが並んでいます。Chat Completions にこれらを後付けするのは構造的に無理があるので、まあそうなるよねという感じ。
Responses API の関数ツールは、Chat Completions の入れ子構造(function: {name: ...})ではなくフラットな形式です。関数ツールは Responses のフラットなツール形式を使うとドキュメントにもあります。移行で一番最初に踏む地雷がここでした。
tools = [{
    "type": "function",
    "name": "get_build_status",
    "description": "指定ブランチの最新CIビルドの状態を返す",
    "parameters": {
        "type": "object",
        "properties": {"branch": {"type": "string"}},
        "required": ["branch"],
        "additionalProperties": False,
    },
    "strict": True,
}]
ツール呼び出しの2ターン往復を実装する
流れとしては「モデルが function_call を返す → 自分でその関数を実行する → 結果を function_call_output として入力に積んで再度投げる」の2往復です。コードにするとこう。
import json
from openai import OpenAI

client = OpenAI()

def get_build_status(branch: str) -> dict:
    return {"branch": branch, "status": "success", "duration_sec": 92}

messages = [{"role": "user", "content": "main ブランチのCIは通ってる?"}]

first = client.responses.create(
    model="gpt-6-astra",
    input=messages,
    tools=tools,
    reasoning={"effort": "low"},
)

for item in first.output:
    messages.append(item)  # reasoning item も含めてそのまま積む
    if item.type == "function_call":
        args = json.loads(item.arguments)
        result = get_build_status(**args)
        messages.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(result, ensure_ascii=False),
        })

second = client.responses.create(
    model="gpt-6-astra",
    input=messages,
    tools=tools,
)

print(second.output_text)
ポイントは2つあって、ひとつは call_id(id ではない)で紐付けること。もうひとつは、first.output を丸ごと積み直していることです。推論モデルは function_call の前に reasoning item を出すことが多いようで、それを落とすとツール実行後の精度が落ちるケースがあるようです。store=True にして previous_response_id を渡すやり方もあるようですが、ステートレスに保ちたい場合は手で積むほうが扱いやすいかなと。このあたり、正直まだベストプラクティスを掴みきれていません。
ツール定義を関数から自動生成する
ツールが増えてくると JSON Schema を手書きするのが地味につらいので、型ヒントから生成するデコレータを書いてみました。これは API を叩かないので手元でそのまま動きます。
import json, inspect

REGISTRY = {}

def tool(fn):
    sig = inspect.signature(fn)
    props, required = {}, []
    for name, p in sig.parameters.items():
        t = {str: "string", int: "integer", float: "number", bool: "boolean"}[p.annotation]
        props[name] = {"type": t}
        if p.default is inspect.Parameter.empty:
            required.append(name)
    REGISTRY[fn.__name__] = {
        "schema": {
            "type": "function",
            "name": fn.__name__,
            "description": (fn.__doc__ or "").strip(),
            "parameters": {
                "type": "object",
                "properties": props,
                "required": required,
                "additionalProperties": False,  # ここ注意
            },
            "strict": True,
        },
        "fn": fn,
    }
    return fn

@tool
def get_build_status(branch: str) -> dict:
    """指定ブランチの最新CIビルドの状態を返す"""
    return {"branch": branch, "status": "success", "duration_sec": 92}

@tool
def convert_jpy(amount: float, rate: float) -> dict:
    """ドル金額を日本円に換算する"""
    return {"jpy": round(amount * rate)}

def dispatch(name, arguments_json):
    entry = REGISTRY[name]
    return entry["fn"](**json.loads(arguments_json))

print(json.dumps([v["schema"] for v in REGISTRY.values()], ensure_ascii=False, indent=2))
print("---")
print(dispatch("get_build_status", '{"branch": "main"}'))
print(dispatch("convert_jpy", '{"amount": 12.5, "rate": 155.2}'))
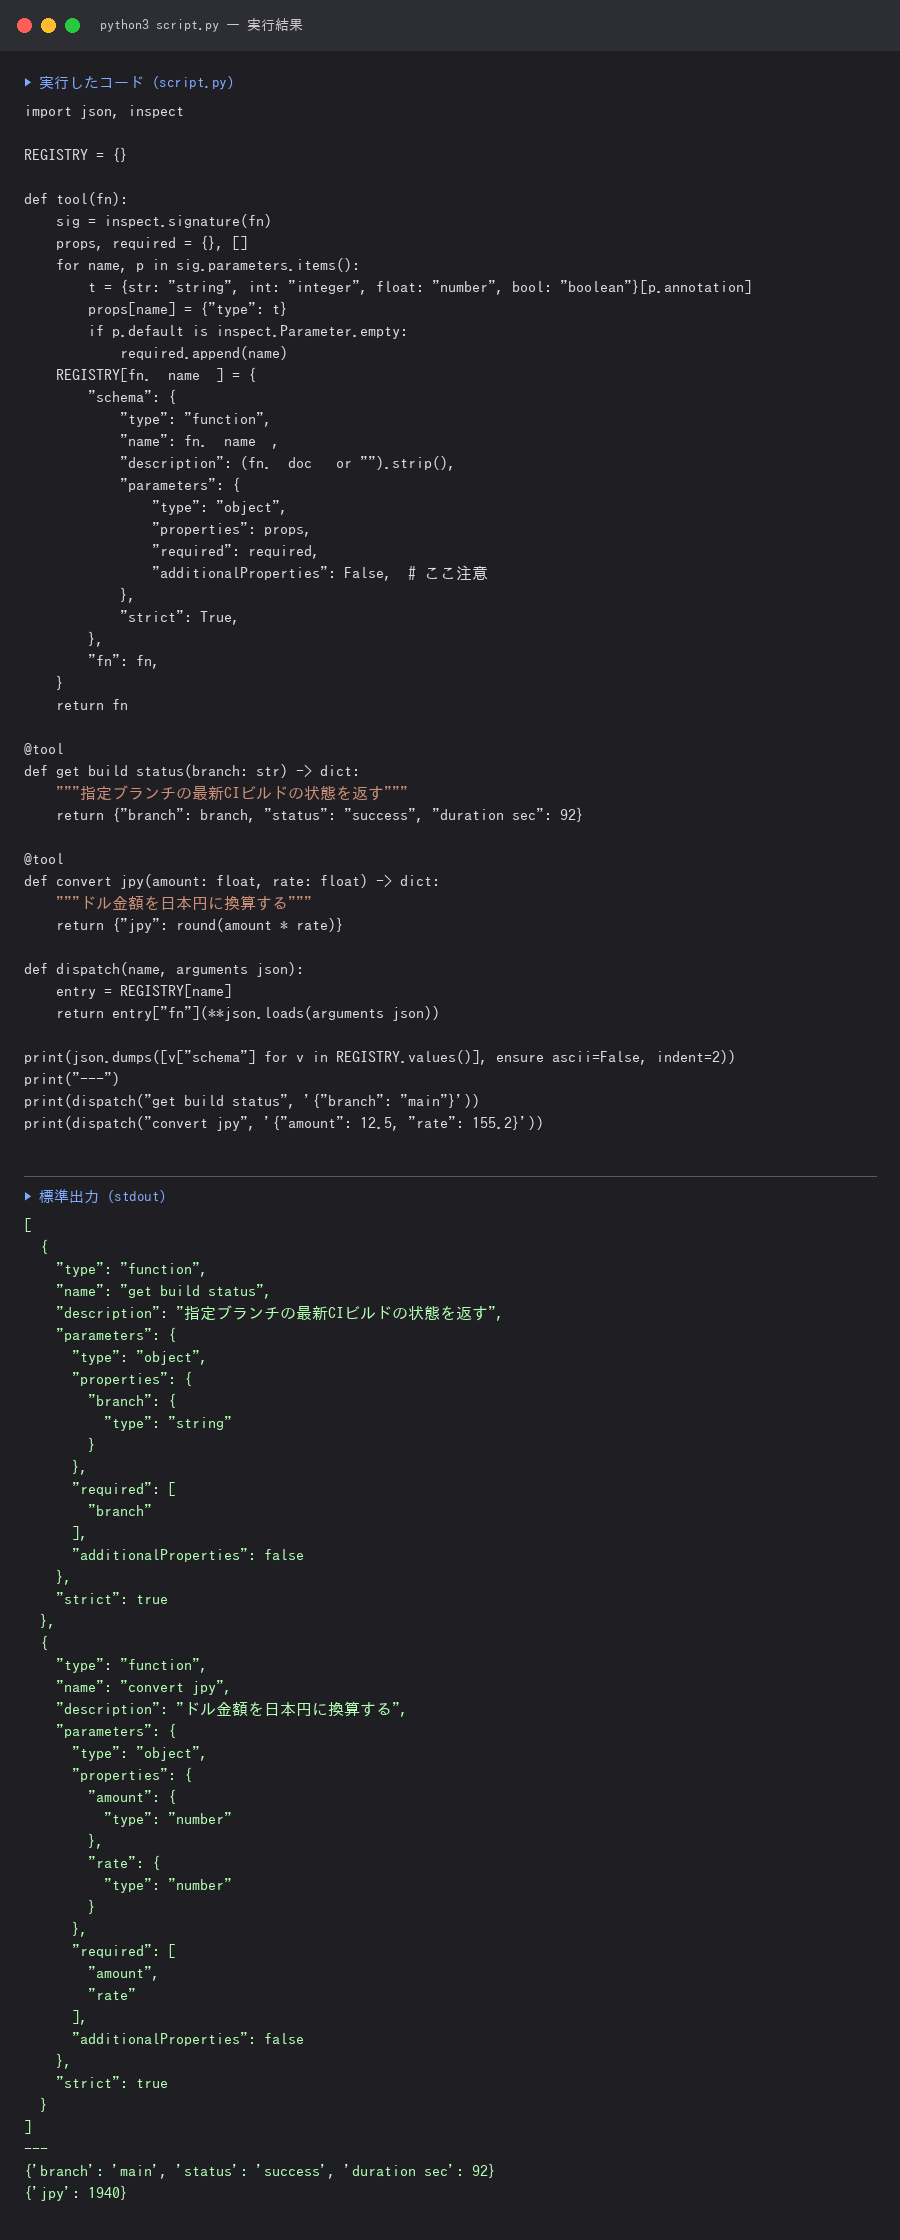
▲実際にこのブログの裏側で実行してみた結果です
strict: True を使う場合、additionalProperties: False と、全プロパティが required に入っていることが条件になります。オプション引数を表現したいときは required から外すのではなく ["string", "null"] のような型にするのが作法らしいです。上のデコレータはそこまで面倒見てないので、使うなら足してください。
余談ですが、Cursor でこのデコレータを書いてたら「Pydantic 使えば?」と提案されました。正論です。ただ依存を増やしたくなかったのと、JSON Schema が実際にどう組み立てられるか自分の手で確認したかったので、今回は標準ライブラリだけにしました。
移行時にハマりやすいポイント
reasoning={"effort": "none"}は通らない。Astra では none が廃止されたので、軽い処理は low に置き換えるtemperatureを残したままだとエラーになるようです。設定ファイルから渡している場合は見落としやすい- ツール形式がフラット。Chat Completions 用の定義をそのまま持ってくると弾かれる
- 出力トークンに reasoning 分が乗るので
max_output_tokensは余裕を持たせる - Batch と Flex は半額、Fast モードは倍額とされています。非同期でいい処理は Batch に逃がすのが素直
ちなみに Azure と AWS Bedrock でも使えて、OpenRouter では openai/gpt-6-astra として提供されているようです。自分は普段AWSに寄せているので、Bedrock 経由だとどこまで同じ書き味でいけるのか気になっているところです。
※この記事にはプロモーションが含まれます
余談ですが、GPT-6 Astraのツール呼び出しを実装してる最中に画像処理まわりを調べてたら、Aiarty Image Enhancer というツールをたまたま見つけて、ちょっと気になってます。
まとめ
ツール呼び出しの基本はここまでです。要点は「Astra のツール呼び出しは Responses API 前提」「ツール定義はフラット形式」「reasoning item を含めて output を積み直す」の3つです。
ストリーミング中に function_call が来たときの引数の組み立て、みんなどうやってるんでしょう。良いやり方をご存知の方がいたらこっそり教えてほしいです。
📚 GPT-6 Astra API を基礎から使うなら
- GPT-6 Astra APIのPython入門|旧コードが通らない理由(環境構築・APIキーの設定・最初のリクエスト・使えないパラメータ)