前回(第1回)は Terraform って結局何なのかという話と、インストールから terraform init / plan / apply でAWS上にリソースを1つ作って壊すところまでを紹介しました。今回はその続きで、tfファイルの中身、特に変数(variable)・出力(output)・データソース(data)の書き方と、「tfstate どこに置くのが正解なの?」という問題をまとめます。
というのも、第1回のあと調子に乗って手元でリソースを増やしていたら、main.tf が200行を超えてリージョン名とインスタンスタイプが7箇所くらいにベタ書きされている状態になりまして。さすがにこれはまずいなと。
この記事でわかること
- variable / locals / output の使い分け
- 変数に値を渡す方法が何種類もある件と、その優先順位
- data ソースで「既にあるもの」を参照する書き方
- tfstate の正体と、初心者が最初にやるべき管理方法
variable:型を指定して入口を守る
ベタ書きを変数に切り出すだけなら3行で済みます。慣習的に variables.tf というファイルに分けることが多いっぽいです(分けなくても動きます、Terraformはディレクトリ内の .tf を全部まとめて読むので)。
variable "region" {
  type    = string
  default = "ap-northeast-1"
}

variable "instance_type" {
  type        = string
  default     = "t3.micro"
  description = "検証用なので小さめ"
}

variable "tags" {
  type = map(string)
  default = {
    Project = "nyanchu-lab"
    Owner   = "nyanchu"
  }
}
type は省略できるんですが、省略すると何でも入ってしまって、間違った型を渡したときのエラーが「apply 直前によくわからないところで落ちる」になりがちです。書いておくと plan の段階で怒ってくれるので、面倒でも書いたほうが結果的に早い気がします。
もう一歩踏み込むと validation ブロックも使えます。
variable "env" {
  type = string

  validation {
    condition     = contains(["dev", "stg", "prod"], var.env)
    error_message = "env は dev / stg / prod のどれかにしてください。"
  }
}
自分はここでタイポして prd と打ったことがあるので、こういう守りは入れておくと精神衛生に良いです。
変数の値を渡す方法と優先順位
変数に値を入れる方法、ざっと数えて5種類以上あります。default、環境変数 TF_VAR_xxx、terraform.tfvars、*.auto.tfvars、-var-file=...、-var 'key=value'。で、これらが競合したときは「後から読み込まれる(指定される)ほうが勝つ」という優先順位があります。
ざっくり自分の理解だと、弱い→強いでこんな感じです:
default(最弱。どこからも値が来なかったときだけ効く)- 環境変数
TF_VAR_<name> terraform.tfvars(+terraform.tfvars.jsonがあればそれも)*.auto.tfvars(+*.auto.tfvars.json、ファイル名の辞書順)- CLI の
-var/-var-file(最強。しかも指定順で後勝ち)
公式ドキュメントを読んでもピンと来なかったので、Pythonで同じルールを書いて動かしてみたら腹に落ちました。
PRECEDENCE = [
    "default",
    "TF_VAR_env",
    "terraform.tfvars",
    "auto.tfvars",
    "-var-file",
    "-var",
]

sources = {
    "default":          {"instance_type": "t3.micro", "env": "dev", "region": "ap-northeast-1"},
    "TF_VAR_env":       {"env": "stg"},
    "terraform.tfvars": {"instance_type": "t3.small", "env": "prod"},
    "auto.tfvars":      {"instance_type": "t3.medium"},
    "-var":             {"env": "hotfix"},
}

resolved = {}
for src in PRECEDENCE:  # ここ注意:後ろほど強い
    for k, v in sources.get(src, {}).items():
        resolved[k] = (v, src)

for k in sorted(resolved):
    v, src = resolved[k]
    print(f"{k:15} = {v:12} (from {src})")
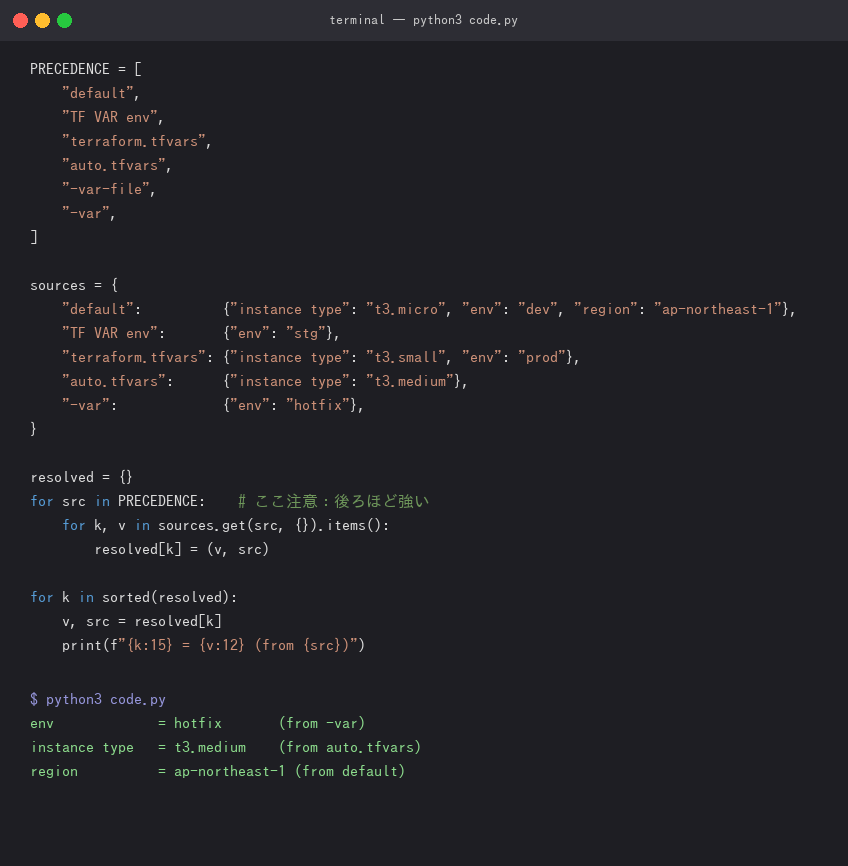
▲実際にこのブログの裏側で実行してみた結果です
実行するとこうなります。
env             = hotfix       (from -var)
instance_type   = t3.medium    (from auto.tfvars)
region          = ap-northeast-1 (from default)
つまり terraform.tfvars に prod と書いてあっても、CLIで -var を付けたらそっちが勝つ。逆に言うと「tfvars に書いたはずの値が効いてない」ときは、だいたい環境変数かCLI引数が上書きしています。自分はこれで30分溶かしました。
locals:ファイルの中で値を組み立てる
variable と locals の違いが最初わからなかったんですが、外から差し込むのが variable、ファイルの中で組み立てるのが locals、という理解で今のところ困っていません。
locals {
  name_prefix = "${var.project}-${var.env}"

  common_tags = merge(var.tags, {
    Environment = var.env
    ManagedBy   = "terraform"
  })
}

resource "aws_s3_bucket" "logs" {
  bucket = "${local.name_prefix}-logs"
  tags   = local.common_tags
}
参照が var. ではなく local.(単数形)なのが地味な罠です。複数形で書いて怒られるのを、まだ月1でやってます。
data ソース:既存リソースを参照する
resource が「作る」ものだとすると、data は「すでにあるものを読む」ものです。AMI IDをベタ書きしていると、しばらくして「そのAMIもう無いよ」と言われて詰むので、data で取るのが定番です。
data "aws_ami" "al2023" {
  most_recent = true
  owners      = ["amazon"]

  filter {
    name   = "name"
    values = ["al2023-ami-2023.*-x86_64"]
  }
}

data "aws_caller_identity" "current" {}
data "aws_availability_zones" "available" {
  state = "available"
}

resource "aws_instance" "app" {
  ami           = data.aws_ami.al2023.id
  instance_type = var.instance_type
  availability_zone = data.aws_availability_zones.available.names[0]
  tags = local.common_tags
}
aws_caller_identity は「今どのアカウントで叩いてるか」を返してくれるので、IAMポリシーのARNを組み立てるときによく使います。本番アカウントと検証アカウントを行き来する人には特に効きそう。
output:計算結果を外に出す
output "instance_public_ip" {
  value = aws_instance.app.public_ip
}

output "db_password" {
  value     = random_password.db.result
  sensitive = true
}
sensitive = true を付けると plan / apply のログに (sensitive value) と出て値が隠れます。ただし——ここ重要なんですが——隠れるのは画面上だけで、tfstate には平文で入ります。ここを勘違いしていた時期があって、危うく tfstate をGitに上げるところでした。
tfstate は何者で、どこに置くべきか
apply すると terraform.tfstate というJSONができます。中身は「Terraformが作ったリソースの実際のIDや属性の記録」です。これがあるから、次に plan したときに「コードの理想」と「現実」の差分が取れる。逆に言うと、これを失うとTerraformは自分が作ったものを忘れます。AWS側にリソースは残っているのに、Terraformは「何もない」と思ってもう一度作ろうとする、という地獄が発生します。
なので初心者が最初に押さえるべきはこの3つです。
- tfstate は
.gitignoreに入れる(*.tfstate,*.tfstate.backup)。秘密情報が平文で入るので - 一人で触っていてもS3などのリモートに置く(PCが飛んだら終わるので)
- 複数人・複数マシンで触るならロックは必須
S3バックエンドとロック管理の新しい形
昔の記事を読むと「S3 + DynamoDB でロック」という構成がだいたい出てきます。自分も最初それで組んだんですが、今は基本的に不要になりつつある印象です。S3バックエンドには use_lockfile(S3ネイティブのロック)があり、Terraform 1.10.0 から使えます。DynamoDBを使うロックは非推奨扱いで、S3ネイティブロックへの移行が推奨されています。
terraform {
  required_version = "~> 1.16"

  backend "s3" {
    bucket       = "nyanchu-tfstate-apne1"
    key          = "lab/dev/terraform.tfstate"
    region       = "ap-northeast-1"
    encrypt      = true
    use_lockfile = true
  }
}
仕組みとしては、state と同じS3上に .tflock という拡張子のロックファイル(オブジェクト)が置かれて、それをロックの代わりにしている感じです(ファイル名は key の指定に依存します)。必要なIAM権限も s3:GetObject / PutObject / DeleteObject が中心で済むので、DynamoDBのテーブル作成やコスト管理をしなくてよくなったのは素直に嬉しい。バケットのバージョニングは必ず有効化しておきます。state が壊れたときに巻き戻せる保険になるので。
backend ブロックには変数が使えません(var.bucket のように書けない)。これは仕様で、環境ごとに変えたい場合は terraform init -backend-config=dev.hcl のように別ファイルで渡します。この制約を知らずに変数化しようとして小一時間悩みました。
ローカルからS3に引っ越すとき
すでにローカルに tfstate がある状態で backend ブロックを追加して terraform init を叩くと、「既存のstateをコピーする?」と聞かれるので yes と答えるだけです。
terraform init -migrate-state移行前にローカルの tfstate をコピーして退避しておくと安心です。自分は念のため cp terraform.tfstate ~/backup/ してからやりました。臆病なくらいでちょうどいい領域だと思っています。
ちなみに state を直接編集したくなる場面(インポートした、名前を変えたい等)もあるんですが、terraform state mv や import ブロックあたりはまだ検証途中なので、ちゃんと詳しくなってから別記事にします。JSONを手で書き換えるのは……たぶんやらないほうがいい。
まとめ
variable で外から値を差し込めるようにして、locals で組み立てて、data で既存リソースを拾って、output で結果を出す。この4つが揃うと、tfファイルが急に「設定ファイル」っぽくなってきます。そして tfstate をS3に逃がした時点で、やっと他人と共有できる構成の入り口に立てた感じがしました。
この記事を書きながら手元の main.tf を分割していたら、使っていないリソースが2つ見つかって静かに destroy しました。コード化すると棚卸しが進むのは副次的なメリットかもしれません。