先週、自分の書いたPythonスクリプトを読み返していたら if key not in d: d[key] = [] という行が3か所出てきて、さすがに何か間に合ってないなと思いました。collections は名前だけ知っていて Counter と defaultdict しか使っていなかったので、この機会に一通り触って自分用に整理しています。
この記事でわかること
defaultdictで初期化チェックを消す方法と落とし穴Counterで集計だけでなく差分や和を計算する使い方dequeで先頭操作を高速化(リストの80倍以上)namedtupleとdataclassの実測サイズ比較ChainMapで設定の優先順位を管理する方法UserDictとOrderedDictの使いどころ- Python 3.14系での collections 関連の変更
defaultdict:キーの存在チェックを書かなくなる
いちばん使用頻度が高いのはこれでした。defaultdict(list) にしておくと、存在しないキーにアクセスした時点でデフォルト値が作られるので、初期化のif文が消えます。
from collections import defaultdict

logs = [
    ("2026-09-01", "lambda-a", "ERROR"),
    ("2026-09-01", "lambda-a", "INFO"),
    ("2026-09-01", "lambda-b", "ERROR"),
    ("2026-09-02", "lambda-a", "ERROR"),
]

by_func = defaultdict(list)
for date, func, level in logs:
    by_func[func].append((date, level))

print(dict(by_func))

nested = defaultdict(lambda: defaultdict(int))
for date, func, level in logs:
    nested2026/09/21[level] += 1

print(nested["2026-09-01"]["ERROR"], nested["2026-09-03"]["ERROR"])
print(len(nested))  # ここ注意
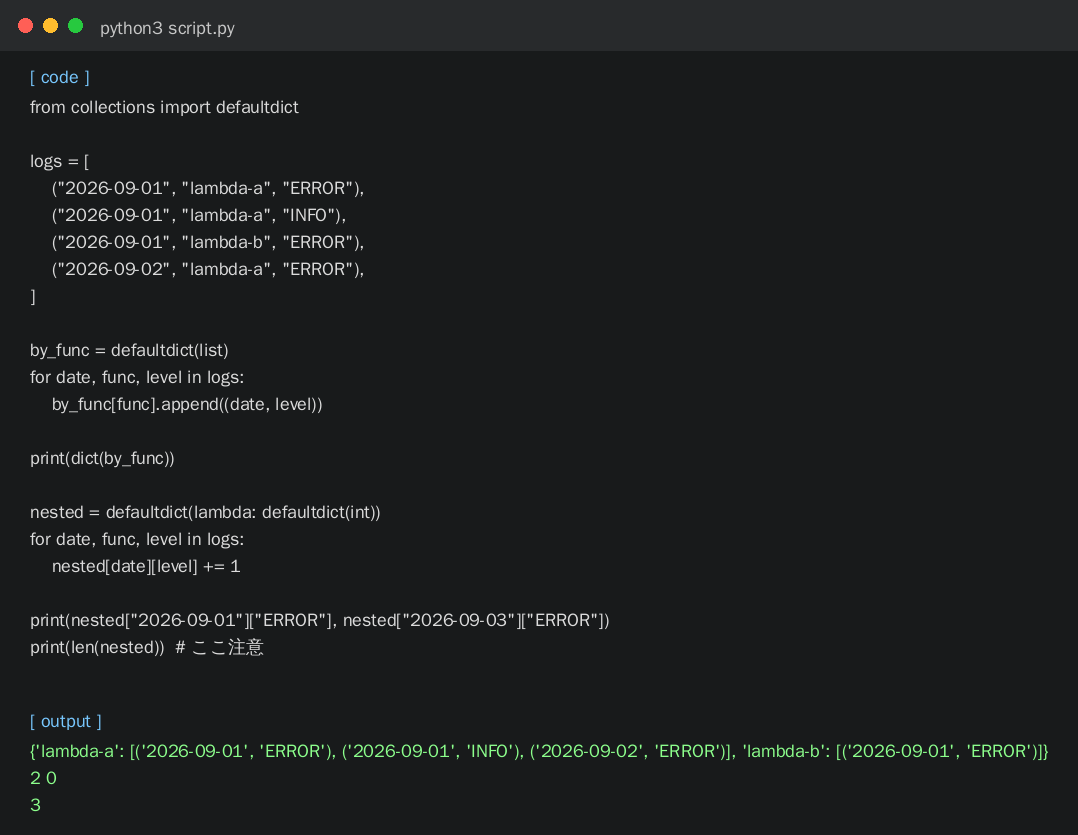
▲実際にこのブログの裏側で実行してみた結果です
ネストさせたいときは defaultdict(lambda: defaultdict(int)) で書けます。defaultdict(defaultdict(int)) だと動かないので、あくまで「呼ばれたら値を返すもの」を渡す、という理解でいます。
そして最後の len(nested) がハマりポイントで、存在しない "2026-09-03" を読んだだけなのにキーが増えて3になります。読み取りが副作用を持つのは、慣れるまでちょっと気持ち悪い挙動でした。集計後にキーを数えるようなコードだと静かにズレるので、参照だけしたいときは nested.get(...) を使うか、集計が終わったら dict(nested) に変換して固めてしまうのが安全かなと。
Counter:数えるだけじゃなく引き算ができる
Counter は「数える」用途しか知らなかったんですが、カウンタ同士の演算のほうが面白かったです。
from collections import Counter

words = "cat dog cat bird cat dog fish".split()
c = Counter(words)

print(c.most_common(2))
print(c.total())
print(c["hamster"])

yesterday = Counter({"cat": 2, "dog": 3, "bird": 1})
print(c - yesterday)
print(c & yesterday)
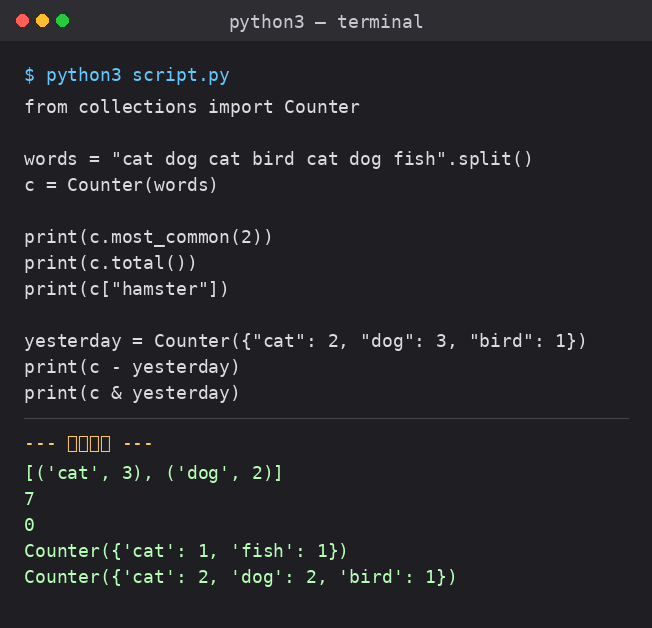
▲実際にこのブログの裏側で実行してみた結果です
実行すると most_common(2) は [('cat', 3), ('dog', 2)]、total() は7、存在しないキーは KeyError ではなく0が返ります。この0返しがあるおかげで、素朴に c[k] += 1 と書けるわけですね。
差分の c - yesterday は Counter({'cat': 1, 'fish': 1}) になります。dog は昨日3で今日2なので -1 のはずですが、減算は0以下を捨てるので消えます。つまり「増えたものだけ」が残る挙動で、日次のアクセスログ比較みたいな用途にはそのまま使えます。逆に増減を両方見たいなら subtract() のほうで、こちらはマイナスを保持してくれます。&(積集合=小さい方を採用)も地味に便利です。
ちなみに total() はPython 3.10で入ったメソッドなので、それ以前は sum(c.values()) でした。自分は最近まで後者を書いていました。
deque:先頭の追加・削除が桁違いに速い
listの pop(0) が遅いというのは知識としては知っていたけど、どのくらい遅いのか測ったことがなかったので測ってみました。
import timeit
from collections import deque

N = 50_000

def with_list():
    q = list(range(N))
    while q:
        q.pop(0)

def with_deque():
    q = deque(range(N))
    while q:
        q.popleft()

print("list.pop(0)  :", round(timeit.timeit(with_list, number=3) / 3, 4), "sec")
print("deque.popleft:", round(timeit.timeit(with_deque, number=3) / 3, 4), "sec")
手元の環境では list が約0.24秒、deque が約0.003秒でした。80倍くらい違います。listは先頭を抜くたびに残り全要素をずらすのでO(n)、それを5万回やるのでO(n²)になる、という話が素直に数字に出ています。要素数が100くらいなら体感差はないでしょうが、キュー的な使い方をするなら最初からdequeにしておくのが良さそうです。
maxlenで「直近N件」が勝手に維持される
from collections import deque

recent = deque(maxlen=3)
for i in range(6):
    recent.append(i)
    print(list(recent))
満杯になると反対側から自動で捨てられるので、最終的に [3, 4, 5] だけが残ります。公式ドキュメントでもUnixの tail に似た機能と説明されていて、直近のリクエストを保持しておく用途や、移動平均の窓なんかにそのまま使えます。自前でスライスして管理するコードを書いたことがあるので、これを先に知りたかった…。
弱点はランダムアクセス
万能ではなくて、真ん中へのインデックスアクセスはlistに負けます。10万要素の中央を10万回読む比較をしたら、listが0.003秒に対してdequeは0.17秒でした。両端O(1)の代わりに中央付近はO(n)寄りになる構造なので、d[i] をループで回すような使い方をするならlistのままのほうが良い、ということですね。あと rotate() というメソッドがあって、これは何に使うのが正解なのか正直まだピンときてないです。
namedtuple・ChainMap・UserDictの使いどころ
残りは使用頻度が下がるものの、刺さる場面がはっきりしている3つ。
import sys
from collections import namedtuple, ChainMap
from dataclasses import dataclass

Point = namedtuple("Point", ["x", "y"])

@dataclass(slots=True)
class DPoint:
    x: int
    y: int

p = Point(1, 2)
print(p.x, p[0], p._asdict(), p._replace(y=99))
print(sys.getsizeof(p), sys.getsizeof(DPoint(1, 2)), sys.getsizeof({"x": 1, "y": 2}))

defaults = {"region": "ap-northeast-1", "timeout": 30, "debug": False}
env = {"timeout": 10}
cli = {"debug": True}

cfg = ChainMap(cli, env, defaults)
print(cfg["region"], cfg["timeout"], cfg["debug"])

cfg["timeout"] = 5
print(cli, env["timeout"])
namedtuple
_asdict() でdict化、_replace() で一部だけ差し替えた新インスタンスが作れます。サイズは手元で namedtuple 56バイト / @dataclass(slots=True) 48バイト / 素のdict 184バイト でした。dictとの差は明確ですが、dataclass(slots)とはほぼ互角でした。なので「メモリのためにnamedtuple」という理由づけは今はあまり強くなくて、インデックスアクセスやアンパックができる=タプル互換が必要かどうかで選ぶのが実際的かなと思っています。型を効かせたいなら typing.NamedTuple のほうが書き味は良いです。
ChainMap
これが個人的に一番の発見でした。CLI引数 > 環境変数 > デフォルト値、みたいな優先順位付き設定を {**defaults, **env, **cli} でマージしていたんですが、ChainMapなら元のdictを壊さず、先頭から探して最初に見つかったものを返してくれます。上の例では timeout が10(env優先)、debug がTrue、region はdefaultsから来ます。
注意点は書き込みで、cfg["timeout"] = 5 は先頭のマップ(cli)にだけ入ります。env 側の10は書き換わりません。読み取り専用のビューとして使うのが素直そうです。
UserDict
dictを継承して __setitem__ をオーバーライドしても、update() や __init__ 経由の代入が拾われないことがあります。UserDict は内部の data 属性に委譲する作りなので、そのあたりが一貫して動きます。HTTPヘッダを大文字小文字を無視して扱うクラスを書いてみたら、コンストラクタに渡したキーもちゃんと小文字化されました。頻繁に使うものではないけど、dictっぽい自作クラスが必要になったときの正解はこれ、と覚えておきたいところ。
あと OrderedDict は、Python 3.7以降のdictが挿入順を保つようになったので出番が減っています。ただ move_to_end() と popitem(last=False) があるので、LRUキャッシュを自作するなら今でもこちら、という認識です。
2026年9月現在のバージョン事情
この記事のコードは3.11で動かしましたが、2026年9月現在の最新安定版は Python 3.14系です。3.15は9月1日に最終リリース候補が出た段階で、正式版は10月予定っぽいです。
で、collections自体は何か大きく変わったのかというと、ほぼ変わっていません。3.10でABCのエイリアス(collections.Mapping のような書き方)が削除されて collections.abc に統一されたのが最後の大きめな変更で、あとは Counter.total() の追加くらい。枯れているモジュールなので、今から覚えても知識の寿命が長いのはありがたいです。
むしろ3.14側の変更で関係しそうなのは、ガベージコレクション周りの変更でしょうか。大量のdequeやdefaultdictをメモリに抱える処理では効いてくるかもしれません。これは自分の手元で差を測れていないので、別途試したいです。
結局どう使い分けるか
ざっくり、キーごとに集める→defaultdict、数える・比べる→Counter、両端をいじる/直近N件→deque、軽い値オブジェクト→namedtuple、設定の優先順位→ChainMap、という整理で自分は落ち着きました。どれも標準ライブラリなのでインストール不要、importするだけで済むのが良いですね。
itertools と heapq も触ってみる予定です。heapq の使いどころが「優先度付きキュー」以外に思いつかないんですが、実務で使っている人はどういう場面で出してるんでしょう。
※この記事にはプロモーションが含まれます
そういえば、Pythonのcollectionsモジュールで効率化したコードをブログにまとめようと思って、レンタルサーバーをいろいろ調べてたらお名前.com レンタルサーバー が目に留まりました。